解説記事を載せている小さなサイトが、ある日サーバーのトラフィックが 3 割増えていることに気づいた。その多くは AI 企業のクローラー(サイトの内容を自動で読み取るプログラム)からだった。運営者はまず全部遮断しようと考えたが、そうすると自分の記事が AI 検索の答えに出なくなり、読者がサイトを見つけられなくなるのではと心配になった。
このジレンマは、すべての AI クローラーを同じものとして扱うことから生まれる。実際には三つの違うことをしに来ていて、サイトとやり取りするものもまるで違う。だから「AI を止めるか止めないか」を決める前に、まずそれぞれのクローラーが何をしに来たのかを見て、用途ごとに別の初期ルールを決めたほうがいい。
Cloudflare は AI クローラーを三つの用途に分けた
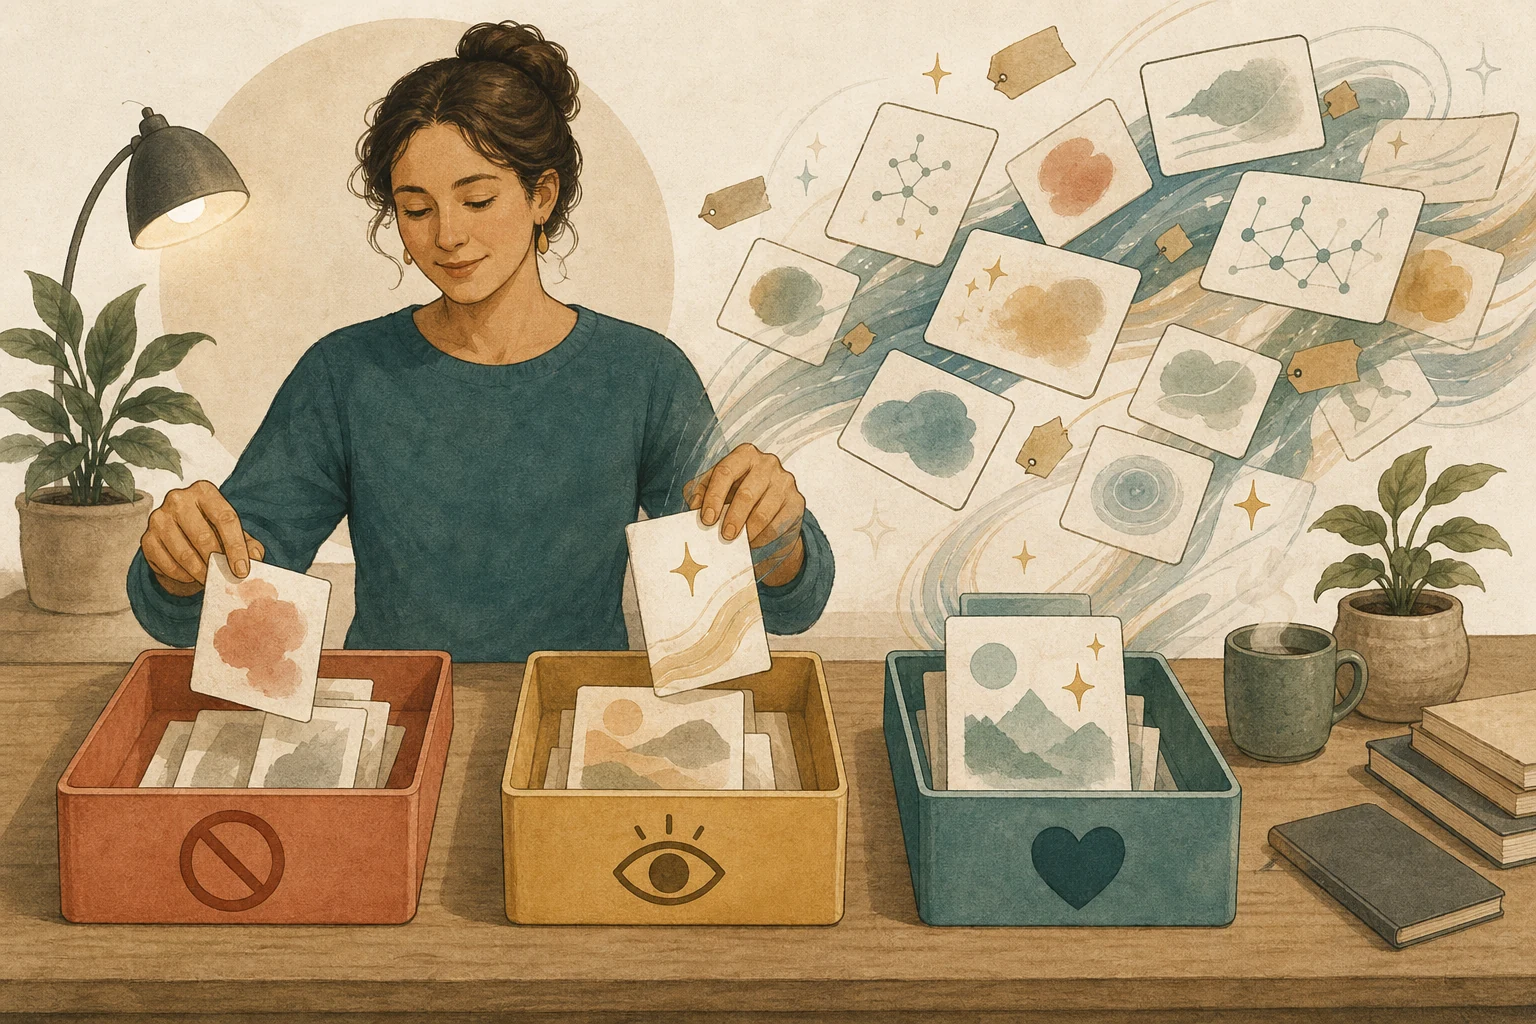
2026 年 7 月 1 日、インターネットサービス企業の Cloudflare は、それまでの「AI ボットを遮断」という一つのスイッチを、サイトが自分で設定できる三つの区分に分けた。
- 検索(Search): サイトの内容を集めて索引を作り、後で質問に答えるのに使う。従来の検索エンジンに最も近く、理屈の上では読者をサイトに連れて戻ってくる。
- エージェント(Agent): ある人のためにその場で動く。チャットボットが会話の途中でページを読む、利用者の代わりにブラウザーを操作する、といったものだ。向こう側ではたいてい誰かが答えを待っている。
- 学習(Training): 内容をモデルの学習や微調整に使う。Cloudflare の言い方では、そのデータはモデルの中に永久に取り込まれる。
Cloudflare はあわせて、2026 年 9 月 15 日から新しく加わるドメインでは、広告を表示するページについてエージェントと学習の用途を初期設定で遮断し、検索は初期設定で許可したままにすると発表した。広告のあるページが求めているのは人の注目であり、人を連れ戻す可能性が最も高いのは検索だから、という理由だ。TechCrunch によると、Cloudflare のクロールごとの課金の仕組みも、コンテンツが生む価値に応じた課金に移るという。
この区分がどのサイトにも合うとは限らない。だが「止めるか止めないか」よりも役に立つ問いを与えてくれる。このクローラーは何をしに来たのか、サイトは代わりに何を得るのか。
三つの用途、三つのやり取り
検索で得るのは露出だ。 サイトは索引に載せられる内容を差し出し、代わりに読者がクリックして来ることを期待する。追うべきは、AI 検索から戻ってくる流入が、取得された量に見合っているかどうかだ。たくさん取られているのに戻ってくる読者がほとんどいないなら、このやり取りは成り立っていない。監視や流量制限に切り替えてよい。
エージェントが持ち込むのは費用と権限の問題だ。 利用者のためにその場でページを読む AI は、短い時間に価格、仕様、サイト内検索を集中して照会することがある。管理すべきは読み取りの頻度と、ログイン後の内容に触れられるか、フォームを送信できるかだ。
学習はライセンスの問題だ。 内容がモデルに取り込まれると、読者が一人も戻ってこないこともある。これは流入の問題というより、「自分の作品を他人に使わせるか」に近い。ふさわしい初期設定は、黙って許可することではなく、ライセンスや料金を求めることだ。
まず最も価値の高いページを守る
最初から完全な規程を書く必要はない。サイトの中で最も価値が高い、あるいは大量に取られやすいページを書き出す。会員向けの内容、有料講座、価格、独自の調査、そしてサイト内検索や絞り込みのように、プログラムが繰り返し照会できる入口だ。許可している用途であっても、こうしたページには追加の制限をかける価値がある。
次に、ルールを実際に効く場所に置く。Cloudflare 自身も説明しているとおり、サイトのルートに置き、クローラーにどこを取ってよいか伝える robots.txt や、新たに加わった内容利用の項目は、サイトの希望を示すだけで、それ自体は何のアクセスも止めない。本当に制限するには、ファイアウォールやボット管理ツールでトラフィックの特徴に応じて速度を落としたり遮断したりする。エージェントが大量のデータを照会する必要があるなら、ページを巡回させるより、認証と流量制限のある API を用意したほうが管理しやすい。学習用途や有料の内容は、最終的には契約とライセンスで扱うもので、技術的なルールは補助にすぎない。
分類できるのは、用途が見分けられるときだけ
用途で分けるには、クローラーの用途を見分けられることが前提になる。だがクローラーの自己申告は偽れるし、大企業のクローラーの中には検索と学習を兼ねているものもある。身元がわからない、あるいは用途が混ざったクローラーについては、実際の振る舞いで判断するしかない。どのページを取ったか、頻度はどれほどか、触れるべきでない場所に触れていないか。
また、ルールは決めたら終わりではない。AI 検索からの流入もクローラーの振る舞いも変わる。現実的なのは、月に一度振り返ることだ。用途ごとのリクエスト量、戻ってきた読者、サーバー費用、価値の高いページへのアクセスの状況を見て、調整するかどうかを決める。
次の一歩として、1 ページの方針を書いてみてほしい。三つの用途それぞれの初期判断、追加で守るべきページ、それぞれを実行する道具、毎月の振り返りの担当者だ。サイト自体がまだ AI に正しく読める状態でないなら、サイトに AI 用の入口は必要か。その仕事が「読む」「調べる」「動く」のどれかで決まるを参考にしてほしい。AI 検索に引用されたとき各ページが何を得るのかが気になるなら、Google の AI 検索から外れるかどうかは、要約されたあとも読み手がサイトに来る理由があるかで考えるも参考になる。
AI 整理カード
AI クローラーのアクセス方針の下書きを AI と作る このプロンプトは、まずサイトの内容と現状を確認し、検索、エージェント、学習の三つの用途ごとに初期判断を決めたうえで、追加で守るべきページと実行の方法を示す。
自分のサイトの AI クローラーのアクセス方針を下書きしたい。
判断方法はこの記事による:https://boosterminiclass.com/ja/posts/ai-crawler-access-policy-checklist/
記事の見方はこうだ。「AI を止めるか止めないか」というスイッチ一つで決めない。AI クローラーには三つの用途がある。検索(露出との交換)、エージェントによる即時の読み取り(費用と権限の問題を持ち込む)、学習(ライセンスの問題)で、初期判断はそれぞれ違うべきだ。robots.txt は希望を示すだけで、本当の制限はファイアウォール、API の流量制限、契約で行う。

まず私に 3 つ質問してほしい:
1. サイトのコンテンツの種類は何か。どれが公開で、どれが会員向けや有料か;
2. いまどの AI クローラーが取得に来ているのが見えるか。それぞれのリクエスト量はおおよそどれくらいか(わからなければ、わからないと答える);
3. コンテンツのライセンスを決めるのは誰か。サイトの技術的な設定を管理するのは誰か。

私の回答をもとに、次を出力してほしい:
- 三つの用途それぞれの初期判断(許可/監視または流量制限/ライセンスや料金を求める/遮断 のいずれか)と理由;
- 追加で守るべき価値の高いページの一覧;
- 各ルールを robots.txt、ファイアウォールやボット管理、API の流量制限、契約のどれで実行すべきか;
- 毎月見直すべき数字。
情報が足りないところは「要確認」とし、推測しないこと。最後に、方針を決めるのはサイトの責任者だと念押ししてほしい。
方針は出発点にすぎない。どの内容を AI に使わせるかは、最終的にサイトの責任者が決める。
参考資料
- Cloudflare Blog:Your site, your rules: new AI traffic options for all customers — https://blog.cloudflare.com/content-independence-day-ai-options/(2026-07-01)
- TechCrunch:Cloudflare’s new policy pushes AI companies to pay for publishers’ content — https://techcrunch.com/2026/07/01/cloudflares-new-policy-pushes-ai-companies-to-pay-for-publishers-content/(2026-07-01)
- Cloudflare Blog:Introducing pay per crawl: Enabling content owners to charge AI crawlers for access — https://blog.cloudflare.com/introducing-pay-per-crawl/(2025-07-01)