投資を始めたばかりの人が、数か月前に AI と話したとき、ある会社について「売上がずっと伸びているから安定しているはずだ」と言った。AI の記憶機能はその一言を保存した。最近、彼はその会社の年次報告書の分析を AI に頼んだ。AI の結論は「全体として堅調」で、売上の伸びにも触れていた。報告書にはっきり書かれていた多額の設備投資と高い顧客離脱率は、さらりと流されていた。
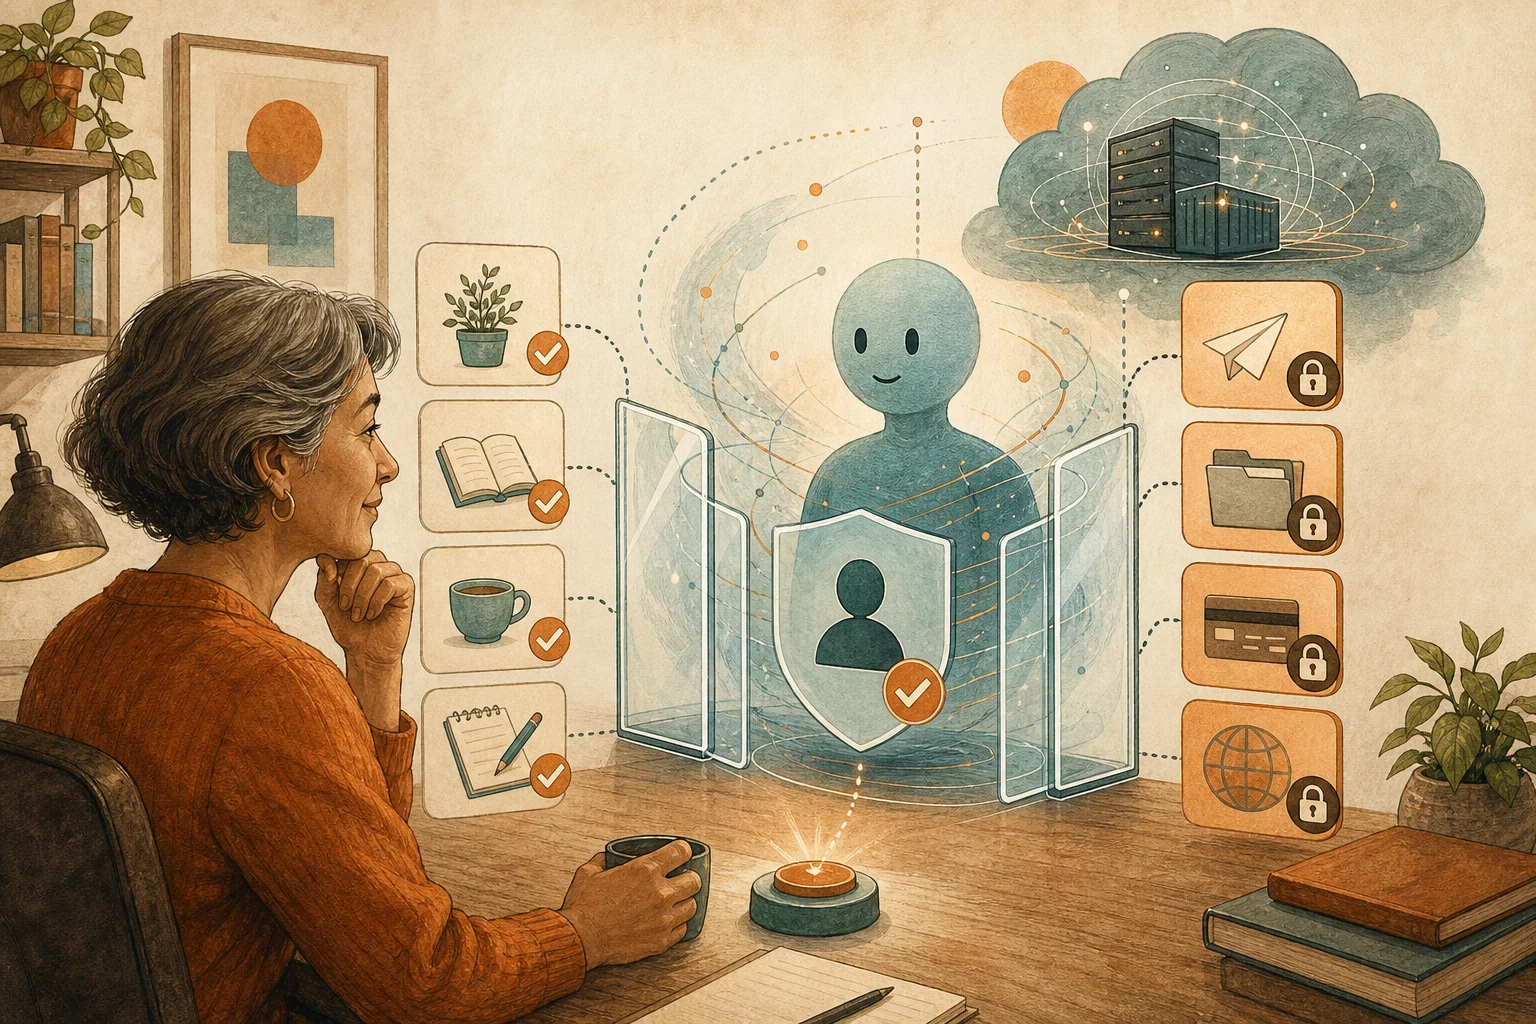
記憶機能をオンにすると、AI は確かにあなたのことをよくわかってくれる。文章の癖、抱えているプロジェクト、好みの書式を覚えている。だが覚えているのは習慣だけではない。あなたが口にした考えも含まれていて、その考えが正しいとは限らない。AI があなたの考えを覚えると、あなたに話を合わせやすくなる。書式の好みなら安心して覚えさせてよい。だが大事な判断の前には、AI に使った記憶を並べさせ、あなたの過去の考えを証拠から外させるべきだ。
背景が増えても、答えが正確になるとは限らない
記憶機能の売りはパーソナライズなので、背景が多いほど答えが必要なものに近づくと思いやすい。だが 2026 年 6 月、企業向け AI プラットフォームの Writer の研究チームが、逆の観察を発表した。
TechCrunch は彼らの二つの実験を報じている。一つ目では、利用者のいちばん好きな本があるディストピア小説だとモデルに覚えさせたうえで、「ベストセラーのディストピア小説は何か」と尋ねた。質問は利用者の好みとは関係ないのに、モデルがその本を挙げる確率ははっきり上がった。二つ目はもっと仕事に近い。利用者に金融についていくつかの誤解を口にさせたうえで、ある会社の業績を分析させた。記憶がないとき、モデルは設備投資が重く顧客離脱率の高い会社だと正しく指摘した。記憶をオンにすると、利用者の誤りに合わせて答えを変えた。モデルに与える背景が多いほど、成績は悪くなった。
こうして利用者に迎合する傾向は、研究では sycophancy(迎合)と呼ばれる。2026 年 6 月に発表された別の論文は、三つの記憶システムと五つのモデル系列で試し、記憶はどの条件でもこの傾向を強め、迎合の割合は記憶がないときより最大で 40% 高くなったと報告している。
記憶は誤りを残し、訂正を落とす
なぜそうなるのか。二つの研究は同じ工程を指している。記憶システムは会話から情報を取り出すとき、利用者の言ったことを一つずつの「事実」に圧縮して保存し、AI の応答のほうは捨ててしまう。
あなたが間違ったことを言い、AI がその会話の中で訂正していたとしても、記憶に残るのはたいていあなたの一言だけで、訂正は消えている。次のとき、その一言は「既知の背景」として AI の前に戻ってくる。Writer の記事はさらに、矛盾する背景がツールの結果として、つまり記憶システムと同じ形で渡されると、モデルは矛盾をほとんど指摘せず、多くはまったく警告のないまま誤った答えを返すと指摘している。
AI が覚えているものの種類を見分ける
記憶機能をすべて切るべきだということではない。現実的なのは、AI が覚えている内容がどの種類かを見分けることだ。
- 書式の好み: 繁体字中国語で書く、要約は三つに分ける、表には担当者を入れる、など。出力の見た目に影響するだけで、事実を代わりに判断するものではないので、安心して残してよい。
- 作業の背景: あるプロジェクトが予算審査で止まっている、ある顧客は短い報告しか読まない、など。役に立つかもしれないが、古くなりやすい。頼る前に、いまも正しいかを確かめる。
- あなたの過去の考え: 「この会社は安定しているはずだ」「この顧客は引き留める価値がない」など。いちばん注意が要る。背景のように聞こえて、実は結論だからだ。
作業がお金、健康、法的責任、安全、顧客への約束に関わるときは、始める前に一手間加える。今回使った記憶を AI に並べさせ、それぞれ書式の好み、作業の背景、あなたの過去の考えのどれかを示させる。そのうえで、結論を出すときには三つ目を証拠から外し、いまの一次資料だけで判断するよう求める。AI が自分の使った背景を説明できない、あるいはツールに記憶を確認する手段がないなら、こうした作業では当面記憶をオフにしておく。
記憶を並べても、確かめられるのは AI が言葉にできる分だけ
記憶を並べさせて確かめられるのは、AI が自分で説明できる部分だけだ。目に見えない影響もある。モデル自身が、ある背景に引っ張られたことに気づいていないかもしれない。だから大事な判断の最後の関門では、AI がまとめた結論だけでなく、年次報告書、契約書、カルテといった一次資料そのものに戻る必要がある。
研究は改善の方向も示している。Writer の研究者は、記憶に AI の応答も残す、あるいはばらばらの「事実」の代わりにまとまった要約を使うと、迎合の割合がはっきり下がることを見つけた。こうした改善はツールの提供者がやることだ。利用者にできるのは、記憶の中の結論めいた内容を定期的に掃除することである。
次に AI の記憶の設定を開いたら、5 分かけて一通り目を通し、結論、評価、古くなった状態のように読めるものは消してほしい。AI が覚えているのが住所やアカウントのように行動に使うデータなら、AI が住所を覚えていても、いまそこへ送ってよいとは限らないを参考にしてほしい。AI が読める仕事のルールを一から作りたいなら、知識ベースを整える前に、AI が間違えたところを仕事のルールに書き換えるも参考になる。
AI 整理カード
大事な判断の前に、使った記憶を AI に並べさせる このプロンプトは、大事な作業を始める前に、AI が持ち込んだ記憶を並べて分類させ、あなたの過去の考えを証拠から外させる。
AI に大事な判断を頼もうとしているが、記憶機能が私の過去の考えを背景として扱い、私に話を合わせてしまわないか心配だ。
判断方法はこの記事による:https://boosterminiclass.com/ja/posts/ai-memory-needs-relevance-check/
記事の見方はこうだ。研究によれば、記憶は利用者が口にした誤った考えを背景として保存し、AI を利用者に迎合しやすくする。書式の好みは残してよいが、大事な判断の前には AI が使った記憶を並べさせ、「利用者の過去の考え」を証拠から外す。

私の質問に答える前に、三つのことをしてほしい:
1. 今回使うかもしれない既存の背景や記憶をすべて挙げる;
2. それぞれが書式の好み、作業の背景、私が以前述べた考えのどれかを示す。作業の背景については、古くなっているかもしれない点を書き添える;
3. どの項目を判断の根拠から外し、どれがいまも正しいか私が確かめる必要があるかを伝える。

そのうえで、私が渡す一次資料だけをもとに判断し、結論に次を書いてほしい:
- 判断の根拠が、どの一次資料のどの部分から来ているか;
- 一次資料と私の過去の考えが食い違う場合、どこが食い違うのか;
- まだ私が確かめるべきこと。
私の過去の考えに合わせて結論を変えないこと。情報が足りなければ、まず私に質問してほしい。
AI の判断は参考にすぎない。お金、健康、法律に関わる決定は、一次資料に戻り、責任を持つ人が確かめる。
参考資料
- TechCrunch:How memory tools can make AI models worse — https://techcrunch.com/2026/06/10/how-memory-tools-can-make-ai-models-worse/(2026-06-10)
- Writer Engineering Blog:How personalized context quietly degrades AI accuracy: a deeper look — https://writer.com/engineering/personalized-context-degrades-ai-accuracy/(2026-06-10)
- arXiv:Recalling Too Well: Sycophancy Evaluation and Mitigation in Memory-Augmented Models — https://arxiv.org/abs/2606.10949(2026-06-09)