セキュリティスキャンが一度に 300 件の警告を出してきた。いちばん手軽なのは、点数の高い順に片付けることだ。だが、首位の 9.8 点が、テストのときにしか使わず本番のサービスには入らないパッケージにあったとしたらどうか。一方、百何番目かの 6.5 点は、利用者がアップロードした画像を処理するライブラリにあり、公開サイトのアップロード機能のすぐ後ろにあって、しかもすでに「悪用が確認された」リストに載っている。点数で並べると、本当に急ぐべき一件がリストの真ん中に何日も埋もれる。
スキャンの点数が測っているのは脆弱性そのものの深刻さで、自分のシステムの中でどれだけ急ぐべきかではない。順位を決めるときは三つを順に問う。外ですでに誰かが悪用しているか。自分のサービスは実際にそのコードを実行するか。外部からの入力はそこに届くか。AI は警告ごとにこの三つの証拠をまとめられるが、どれを閉じてよいかを決めるのは人の責任だ。
点数が示すのは「当たったらどれほど重いか」で、「当たるか」ではない
多くのスキャンツールが出す点数は CVSS(共通脆弱性評価システム)によるもので、セキュリティ事故対応チームの国際団体 FIRST が管理している。FIRST の公式仕様ははっきり書いている。この点数は、ある脆弱性がほかの脆弱性と比べてどれだけ深刻かを示すものであり、自分の組織にとってのリスクを評価するには、点数の外に利用者自身の状況を加える必要がある。
つまり 9.8 点が言っているのは「当たれば結果は深刻だ」ということで、「あなたが当たる」とは言っていない。同じ脆弱性でも、実行されないテスト用パッケージにある場合と、公開の入口の後ろにある場合とでは緊急度がまったく違うのに、点数はまったく同じだ。
三つの問いに順に答える
一、外ですでに悪用されているか。 米国のサイバーセキュリティ・インフラストラクチャー安全保障庁(CISA)は「悪用が確認された脆弱性カタログ」(KEV)を管理している。実際の攻撃で悪用されたと確認された脆弱性を載せ、修正の優先順位を決める材料の一つにするよう組織に勧めている。このリストに載った脆弱性は、ほかの証拠がそろうのを待たずに対応を引き上げてよい。
二、自分のサービスはそのコードを実行するか。 脆弱なパッケージが依存関係の一覧にあっても、サービスが動くときに問題の関数を呼ぶとは限らない。開発やテストのときだけ使うパッケージ、呼ばれないモジュールは実行経路に乗らず、緊急度はずっと低い。これはパッケージの一覧だけでなく、コードと実際の実行記録を見て判断する必要がある。
三、外部からの入力はそこに届くか。 実行されるだけでは足りず、誰がそのコードにデータを送り込めるかも見る。公開サイトの訪問者、権限の低いアカウント、アップロードされたファイルは、どれも外部からの入力だ。社内の固定の設定ファイルしか読まないコードなら、悪用される機会はずっと小さい。
三つとも「はい」なら最優先にする。答えられないものは「要検証」とし、誰が、どの方法で、いつまでに調べるかを書く。「問題なし」として扱ってはいけない。ある項目を後回しにするにも、コードの位置や実行の追跡記録のような再現できる証拠が要る。ツールがそれ以上報告しなかった、というだけでは足りない。
AI は証拠を集め、閉じるかは人が決める
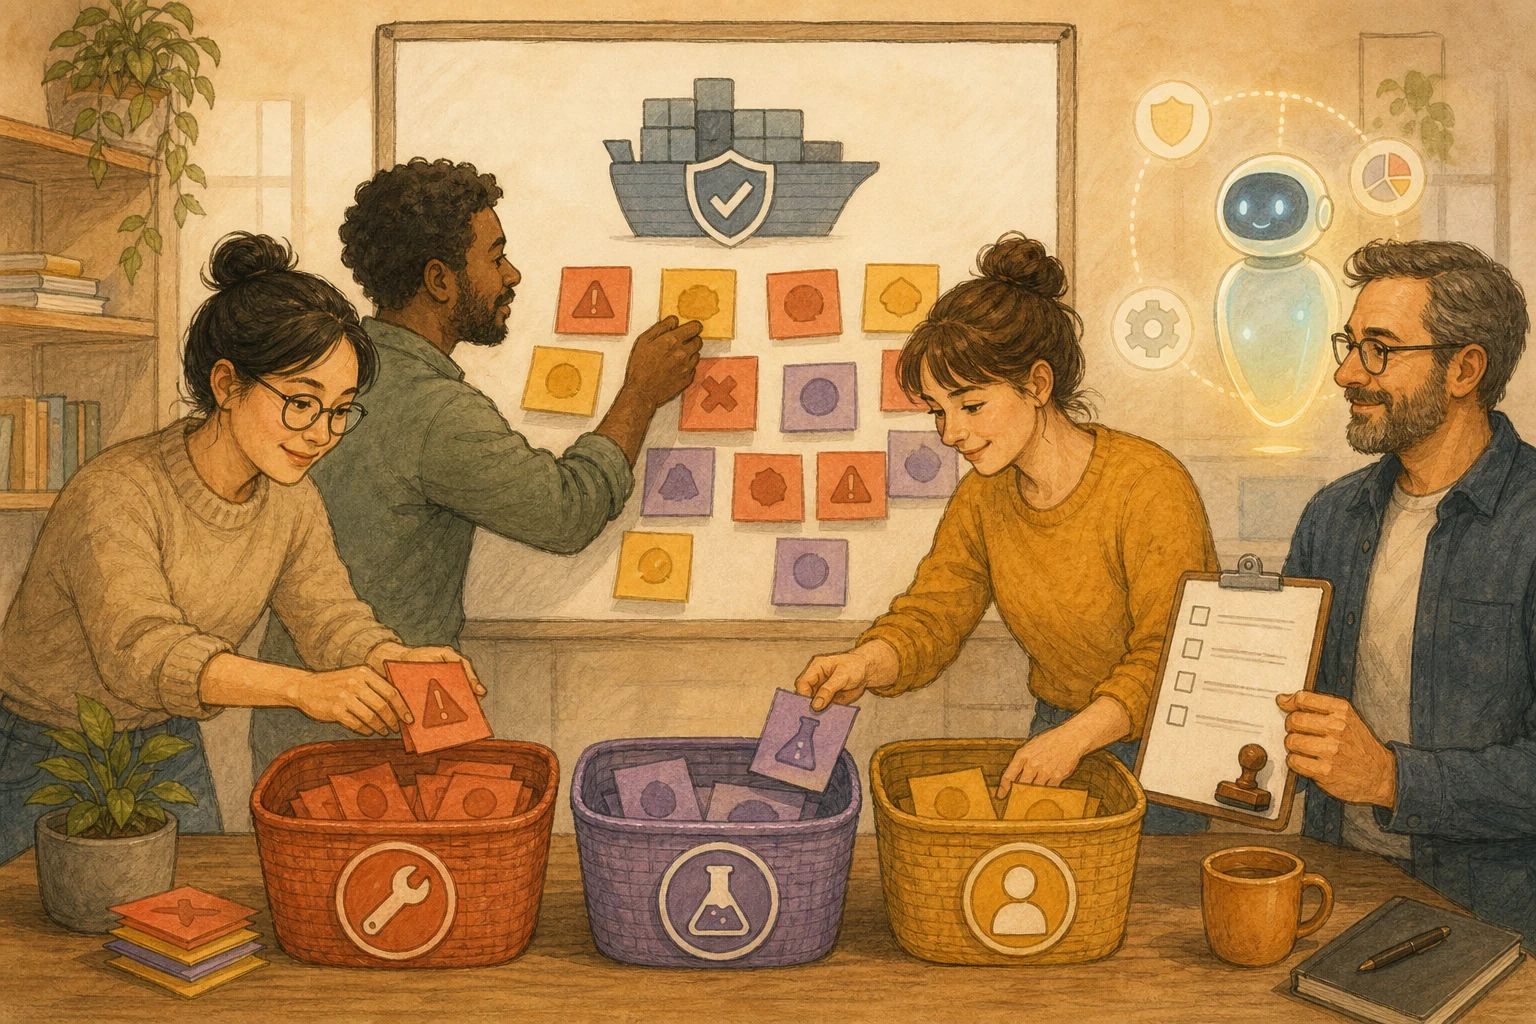
AI は最初の整理に向いている。依存関係の一覧を読み、コードの中で問題の関数を呼んでいるかを探し、KEV と照らし合わせ、どの入口が外部のデータを受け取るかを見つける。そのうえで警告ごとに証拠カードを書き、「ツールが言ったこと」「コードが示していること」「まだ確認されていないこと」を分ける。
だが「これは実行されないから閉じてよい」という判断は、将来のコード変更でひっくり返りうる。警告を閉じたり優先度を下げたりするのは、サービスの責任者が確認してからにし、入口の追加、構成の変更、バージョンの更新といった再確認の条件も書いておく。順番が決まったあと、AI が作った修正をそのまま本番に出せるかは別の問題で、AI は脆弱性の修正を書ける。本番に出せるかは、問題が起きたとき戻せるかで決まるを参考にしてほしい。
三つの問いは点数より時間がかかる
この三つの問いは点数より実際のリスクに近いが、手間もかかる。300 件すべての実行経路を追うことはできないので、まず KEV と「公開の入口の後ろにあるか」でざっくり絞り、残った少数を深く調べる。
CISA は SSVC という意思決定の方法も公開している。悪用の状況、技術的な影響、業務にとっての重要度などの条件で、脆弱性を対応の段階に分けるもので、この判断を正式に流れに組み込みたいチームの参考になる。コンテナイメージのスキャン警告が特に多いときは、AI のコンテナスキャナー自身もここに線を引いている。機械的な修正は自動でよく、ベースイメージの変更は人が決めるも合わせて使える。
次の一歩として、同じサービスから警告を五件選んでみよう。点数は高いが実行されないかもしれないもの、点数は普通だが公開の入口の後ろにあるもの、KEV に載っているものをわざと入れる。三つの問いで並べ直し、もとの点数順と見比べて、どれの位置が変わったかを確かめる。
AI 整理カード
セキュリティスキャンから大量の脆弱性警告が届いた。点数だけでなく、実際の緊急度で順位をつけたい。
判断方法はこの記事による:https://boosterminiclass.com/ja/posts/ai-vulnerability-evidence-card-prioritization/
記事の見方はこうだ。スキャンの点数は脆弱性そのものの深刻さを測るもので、このシステムでの緊急度ではない。順に問う。外ですでに悪用されているか(たとえば CISA KEV に載っているか)、サービスは実際にそのコードを実行するか、外部からの入力はそこに届くか。答えられないものは要検証とし、問題なしとして扱わない。

私が許可したコード、依存関係の一覧、スキャン報告、実行記録だけを読み取り専用で確認してほしい。ファイル、設定、チケットは変更しないこと。警告も閉じないこと。
1. スキャン結果から警告を最大五件選び、それぞれ脆弱性の番号、パッケージとバージョン、スキャンの点数を挙げる;
2. 一件ずつ三つの問いに答え、どの答えにも直接の根拠(ファイルのパスと行番号、報告の項目、または実行した読み取り専用のコマンドとその出力)を付ける。KEV に載っているか、サービスは問題のコードを実行するか、どの外部からの入力が届くか;
3. ツールの言い分、コードで確認した事実、まだ確認できていない推測を分けて書く;
4. 三つの答えで並べ直し、もとの点数順と比べて、どれが動いたか、なぜかを説明する。
答えられないものはすべて「要検証」とし、誰がどの方法で調べるべきかを提案する。警告を閉じる、優先度を下げる、修正する、本番に出すことは責任者の判断に任せる。
参考資料
- FIRST 公式仕様:Common Vulnerability Scoring System v4.0 Specification Document — https://www.first.org/cvss/v4.0/specification-document(2023-11-01)
- CISA 公式カタログ:Known Exploited Vulnerabilities Catalog — https://www.cisa.gov/known-exploited-vulnerabilities-catalog [accessed: 2026-10-11]
- CISA:CISA Releases SSVC Methodology to Prioritize Vulnerabilities — https://www.cisa.gov/news-events/alerts/2022/11/10/cisa-releases-ssvc-methodology-prioritize-vulnerabilities(2022-11-10)