2026 年 6 月、Anthropic は Claude Fable 5 を公開した。公式の説明によれば、分類器が、依頼がサイバー攻撃、生物や化学、あるいは「蒸留」に関わると判断すると、一つ前の世代の Opus 4.8 が代わりに答える。蒸留とは、強いモデルの出力を大量に取り出し、別のモデルの学習に使うことだ。Anthropic はそれ以前にも、許可のない蒸留を防ぐ理由を説明する報告を出していた。
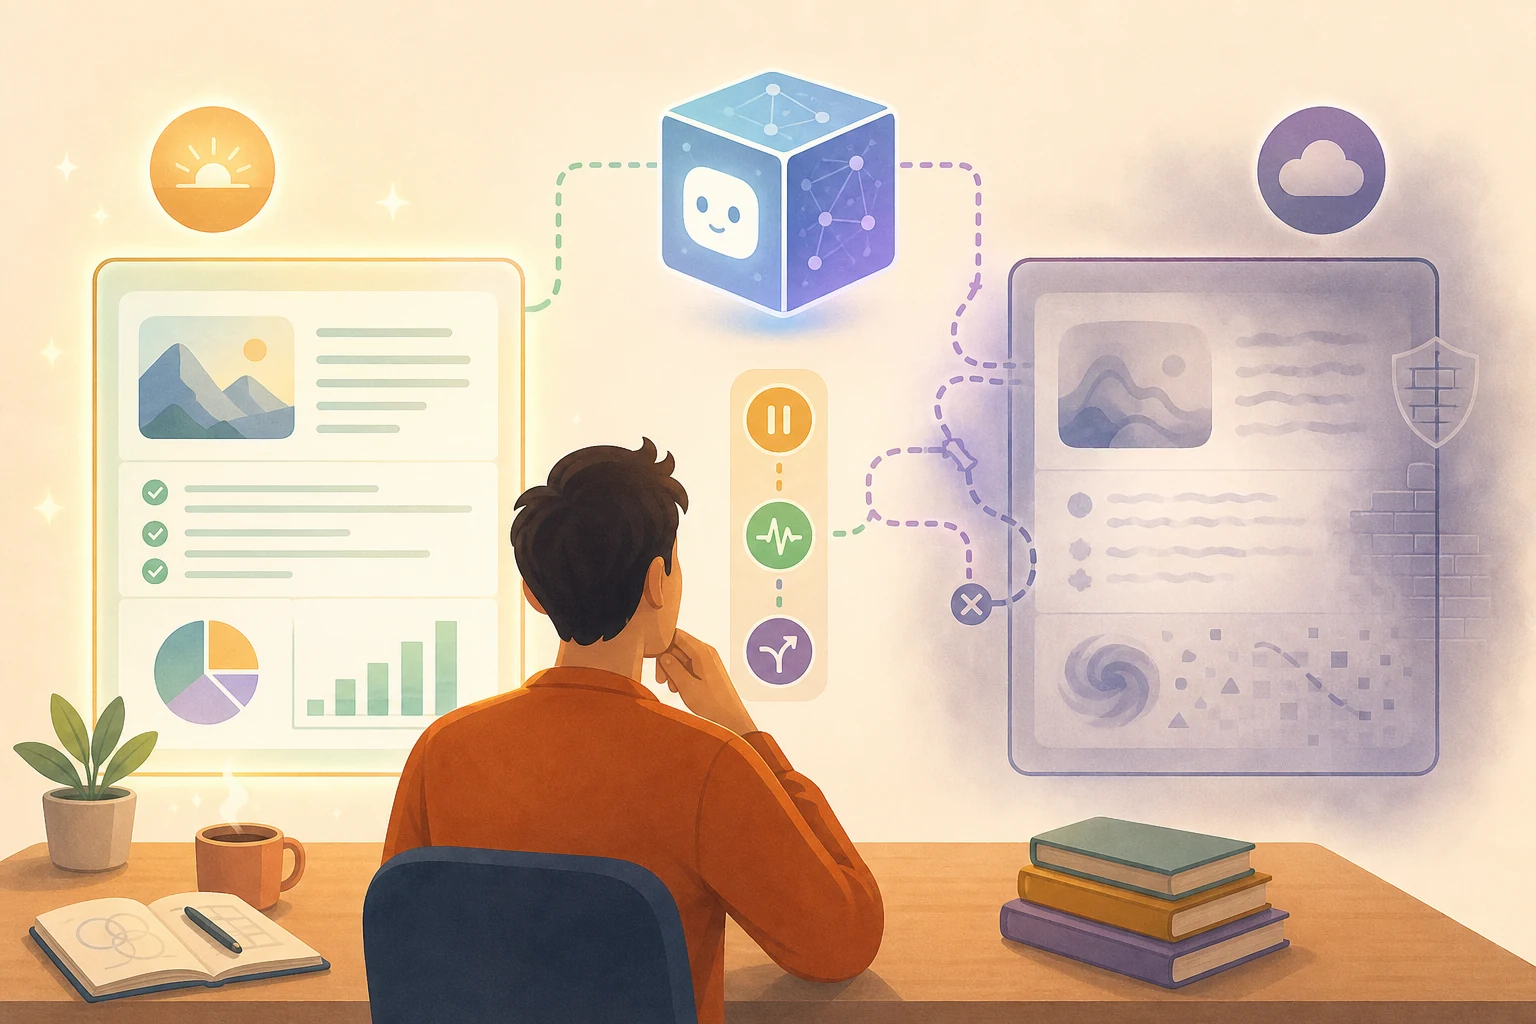
だが Gizmodo の報道によると、最先端のモデル開発という用途に向けた防護の一つは、当初、利用者から見えないように設計されていた。拒否もせず、モデルも切り替えず、依頼をひそかに書き換えて、欠陥のある結果を出していたのだ。研究者や開発者からの強い反発を受け、Anthropic は「誤ったトレードオフをした」と認めて公に謝罪し、こうした防護を利用者に見えるようにすると約束した。
この教訓は一つの会社だけの話ではない。提供元の側の規則、振り分け、防護はいつでも変わりうるし、それはこちらからは見えない。押さえられるのは自分の側だけだ。大事な流れには固定の問題と当時の答えを残しておき、品質が変わったと感じたら、もう一度流して見比べ、印象ではなく証拠で判断する。
「昨日のほうがよかった」は、たいてい印象にすぎない
昨日は研究の要約をきれいにまとめてくれた同じツールが、今日はぼやけて細部を避ける。とっさにプロンプトを書き直し、対話をやり直し、言い方を変えてみる。プロンプトが原因のこともある。だが原因が提供元の側にあるなら、そうした努力はすべて当て推量になる。
もっと困るのは、「昨日のほうがよかった」がたいてい印象にすぎないことだ。昨日の入力と出力を保存していなければ、品質が本当に変わったことを示せないし、いつから始まり、どの結果に影響したのかもわからない。
大事な流れごとに固定の問題を作る
出力が人に伝えられ、納品され、正式な版に取り込まれる流れを選ぶ。研究の要約、顧客への返信の下書き、コードの修正などだ。流れごとに代表的な入力を五〜十問選び、当時のモデル名、日付、出力と一緒に保存しておく。
品質が変わったと感じたら、同じ問題でもう一度流し、保存した答えと見比べて、どの種類の変化かを見る。
はっきりした拒否: モデルが答えられないと言う。少なくとも制限があることはわかり、公式の説明を調べられる。
短く、ぼやけた答え: 以前は出していた細部が抜ける。モデルが別のものに替わった、サービスが更新された、防護が加わった、などが考えられる。
特定の種類の問題だけが悪化: たとえばセキュリティ、医療、データの取り出しに関わる問題だけが悪くなり、ほかは普通。たいていその分野の規則が変わったことを示す。
作業の方向のすり替え: 評価を頼んだのに注意書きが返ってくる。A を聞いたのに、より無難な B が返ってくる。いちばん危ないのはこれだ。答えているように見えて、求めたものではない。
確かめるときは、まず提供元のステータスページ、更新履歴、モデルの文書を見る。Fable 5 の公式の説明はいまでは、Opus 4.8 が代わりに答えるときは利用者に知らせること、それが起きるのは全体の 5% 未満の対話であること、分類器が普通の依頼を誤って拾うこともあることを明記している。書かれている規則があってこそ、照らし合わせられる。
作業のリスクで対応を決める
アイデアの下書きや言い回しの書き換えといったリスクの低い作業なら、品質が落ちたらプロンプトかツールを替えればよく、大がかりな対応はいらない。
研究の要約、社内の報告、コードの下書きといった中くらいのリスクの作業なら、モデルを替えてもよいが、入力と出力の違いを残しておき、新しい結果を古い結論とそのまま比べないようにする。
セキュリティの審査、契約の文言、顧客への約束、本番のコードへの取り込みといったリスクの高い作業なら、固定の問題に差が出た時点で納品を止め、重要な事例を試し直し、再開の時期は担当者が決める。提供元が、ある変更がもともと見えなかったと認めたなら、影響を受けた期間の結果はすべて見直すべきだ。
固定の問題という考え方は、AI にコードを自動で直させる前に評価の基準を決めておくのと同じ理屈だ。AI に速いコードを自動で探させる前に、何をもって「より良い」とするかを書いておくも参考になる。
固定の問題で見つかるのは、試した範囲だけ
固定の問題が見つけられるのは、試した範囲だけだ。提供元の防護は特定の種類の依頼だけを狙うことが多く、問題がそこを含んでいなければ差は見えない。流れの変化に合わせて、問題も定期的に見直す必要がある。
また、差を見つけても原因がわかるとは限らない。「変わった」ことは確かでも、「なぜか」はわからないことが多い。それでも判断には十分だ。どの納品を止め、どのツールに切り替えるかを決められる。AI がいつ止まって人に聞くべきかについては、AI を仕事の流れにつなぐ前に、いつ止まって人に聞くかを決めておくを参考にしてほしい。
AI 整理カード
チームで AI に頼っている大事な流れのいくつかに、固定の問題を作っておきたい。AI の出力の品質が急に変わったとき、印象ではなく証拠で判断できるようにするためだ。
判断方法はこの記事による:https://boosterminiclass.com/ja/posts/claude-fable-invisible-guardrail-checklist/
記事の見方はこうだ。提供元の側の規則、振り分け、防護は、利用者から見えないまま変わりうる。押さえられるのは自分の側だけだ。大事な流れには固定の問題と当時の答えを残し、品質が変わったと感じたらもう一度流して見比べ、作業のリスクに応じて納品を止めるかを決める。

まず私に聞いてほしい。どの流れで AI を使っているか、それぞれの出力を誰に渡しているか、いまどのモデルを使っているか。
そのうえで:
1. 流れを「低」「中」「高」のリスクに分け、理由を書く;
2. 中と高のリスクの流れごとに、固定の問題を五〜十問考える。普通の場面と、制限を受けやすい場面の両方を含め、何を保存するか(モデル名、日付、入力、出力)も示す;
3. もう一度流したあとの見比べ方を書く。「はっきりした拒否」「短く、ぼやけた答え」「特定の種類だけの悪化」「作業の方向のすり替え」の四つを見分けられるようにする;
4. 差が出たときに最初に確かめる公式の情報と、どの納品を止め、誰が再開を決めるかを挙げる。
どの提供元に問題があるかを私の代わりに判断しないこと。方法だけを整理すること。
参考資料
- Gizmodo:Anthropic Apologizes For One of the Guardrails on Its Fable 5 Model, and Will Change It — https://gizmodo.com/anthropic-apologizes-for-one-of-the-guardrails-on-its-fable-5-model-and-will-change-it-2000770365(2026-06-11)
- Anthropic 公式発表:Claude Fable 5 and Claude Mythos 5 — https://www.anthropic.com/news/claude-fable-5-mythos-5(2026-06-09)
- Anthropic 公式発表:Detecting and preventing distillation attacks — https://www.anthropic.com/news/detecting-and-preventing-distillation-attacks(2026-02-23)