金曜の午後、あるエンジニアが「会員データのエクスポートを Excel に対応させる」という issue を coding agent に割り当て、会議に向かった。issue は開発チームが要件を記録する作業票で、coding agent は自分でコードを読み、書き換えられる AI ツールだ。1 時間後に戻ると、pull request、つまりレビューとマージを待つ一連のコード変更がすでに届いていた。変更ファイルは 14、依存パッケージが二つ増え、テストはすべて通っている。diff(変更前後の行ごとの差分)を開いて 3 画面ぶんスクロールしたところで、どの変更が要件に必要で、どれが agent がついでに手を入れたものなのか見分けられないと気づいた。結局、彼は PR を閉じて自分で書き直した。
こういう結末は珍しくない。たいていの場合、agent のコードが悪いわけではない。渡した issue には「何を達成するか」しか書かれておらず、「最初の一歩を終えたら何ができているか」が書かれていなかったのだ。
この抜けはいっそう重くなっている。2026 年 9 月 1 日、GitHub は、GitHub に組み込まれた AI コードレビュー機能である Copilot code review が、管理者の許可があれば pull request を承認できるようになり、その承認がリポジトリ(repo)の必須レビュー数に数えられると発表した。書くのも AI、承認するのも AI になりうるなら、人が判断できる位置はタスクを渡す瞬間まで前に移る。渡す前に、単独でレビューできる最初の diff を書き出せるだろうか。書けないなら、その issue はまだ agent に実装させる段階ではない。
やり切ることと、確かめられることは別だ
coding agent は実際に「最後まで」やれるところまで来ている。GitHub のドキュメントによれば、同社の Copilot coding agent はクラウド環境で repo を調べ、変更を計画し、ファイルを編集し、テストと linter(コードの書き方を自動でチェックするツール)を実行する。branch(独立した作業の流れ)を作り、commit(変更ごとの記録)のメッセージを書いて push し、最後に pull request を開く。もう一つの例が、スタートアップの Cognition が開発する Devin で、エンジニアリング作業を自律的にこなせると打ち出している coding agent だ。Cognition の CEO、Scott Wu は 5 月の TechCrunch のインタビューで、社内エンジニアがコミットしたコードの 89% は Devin によるものだと語り、Devin の実力をジュニアとミドルの中間程度と表現した。
ここから、issue から PR までやれるなら機能ごと任せればいい、という結論を出すのはたやすい。だがこの推論は一つ見落としている。最後までやることと、確認できる形で仕上げることは別だ。
14 ファイルにわたる PR は、たとえ一行残らず正しくても、レビューする側はまず agent の考えた道筋を組み立て直さなければ判断できない。組み立て直せなければ、残る選択肢は二つ。丸ごと受け入れるか、丸ごと差し戻すかだ。前者は誰も本当には理解していないコードを main に入れることになり、後者は agent の 1 時間と自分の 30 分をまとめて捨てることになる。
Wu は同じインタビューで、何をするかは「常に人間が決めるべきだ」と述べている。問題は、その判断が完成した PR を見る瞬間にしか行われないなら、人ができるのは受け入れるか断るかだけで、決めているとは言いにくいことだ。
レビューの手間は diff の範囲に比例する
コードのレビューにどれだけ手間がかかるかは、一度にいくつのことを変えているかで決まる。一つのモジュールだけを変え、テストが一つ付いた diff なら、どこから見ればいいか、何が見えれば正しいかがわかる。データ構造、インターフェース、設定、ドキュメントを同時に変えた diff では、どのファイルから開くかを決めるだけで時間がかかり、変更箇所が一つ増えるたびに確かめるべき前提も一つ増える。
agent はこの傾向をはっきりさせる。ついでに手を入れることが多いからだ。テストを通すためにテスト自体を調整し、新しい関数を使いやすくするために隣のコードまでリファクタリングするかもしれない。一つひとつの動きは筋が通っていても、合わさると、誰も頼んでおらず誰もレビューしていない設計判断になる。
ツール自身も同じことを示している。GitHub のドキュメントには、Copilot coding agent はタスクごとに pull request を一つだけ開き、一度に一つの branch と一つの repo でしか作業せず、1 回のセッションには 59 分の上限があり、出力が不正確または安全でない可能性があるため、本番環境に入れる前にレビューとテストが必要だと明記されている。これらの制約が伝えているのは一つのことだ。渡すタスクは、人が見きれる大きさにしておくこと。
最初の diff を書けないタスクは、まだ渡さない
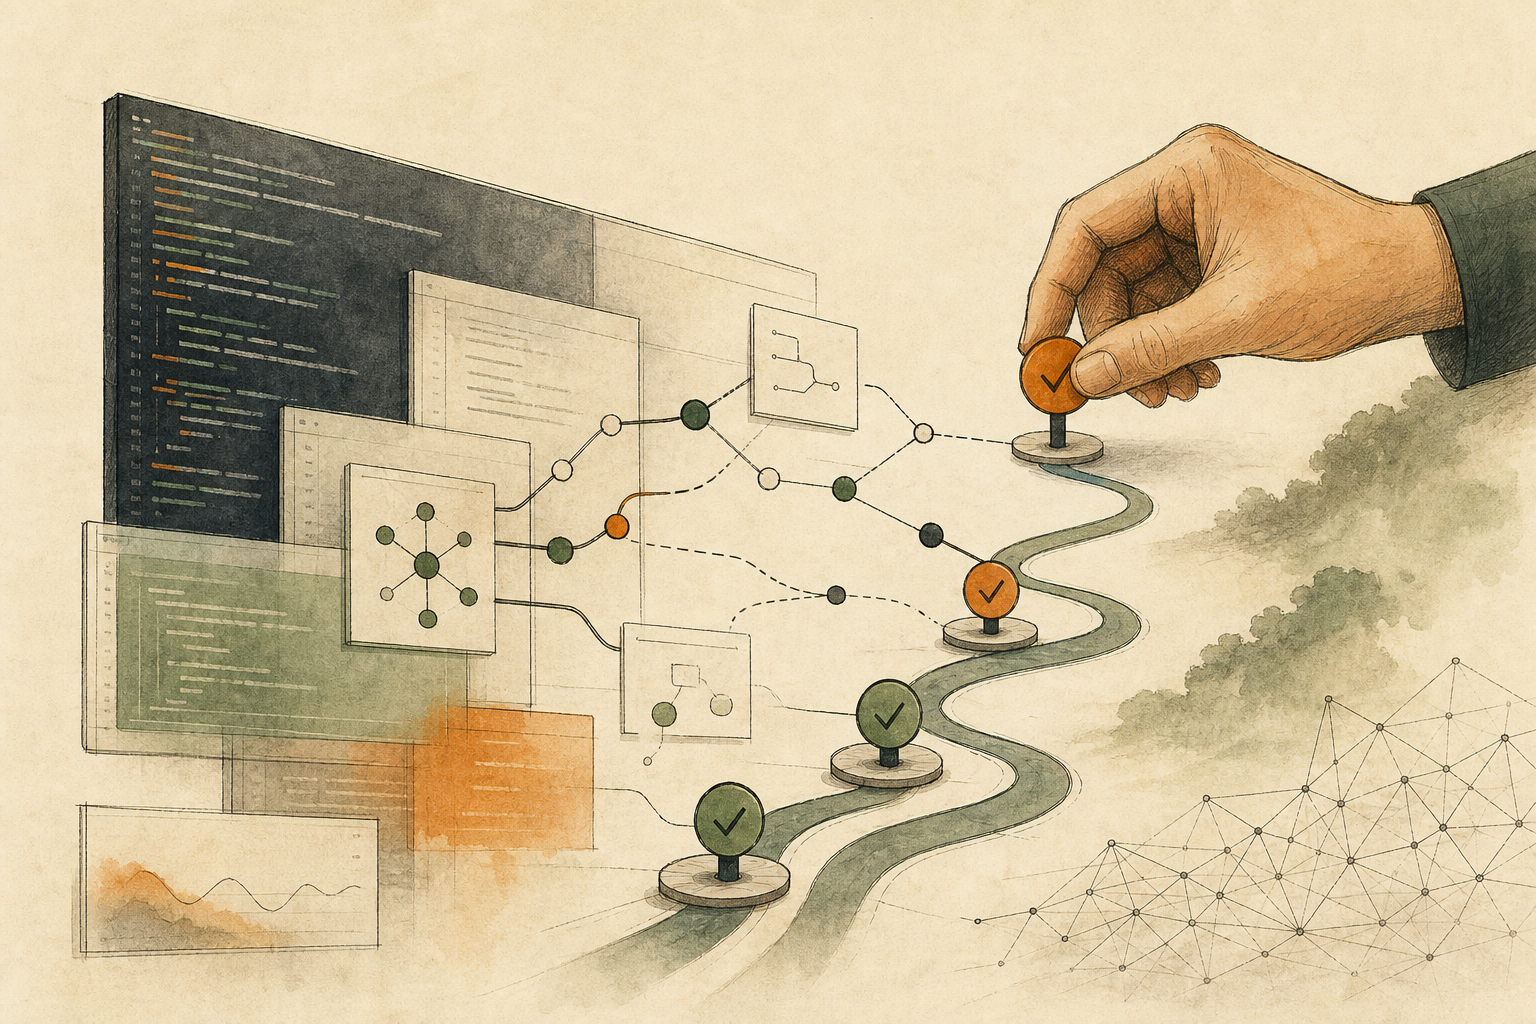
だから、割り当てる前に issue に一行書き足す。「最初の diff は__だけを変え、__で正しさを証明する」。
書ける例はこうだ。「エクスポート機能に Excel 形式を追加する。最初の diff は exporter モジュールに xlsx 出力を足すだけで、会員 10 件をエクスポートして列が CSV 版と一致するというテストで証明する」。こういう issue なら渡してよく、この diff まで進んだら止まり、人が見てから続けるよう agent に指示できる。
書けないときは、たいてい次の三つのどれかで止まっている。
- 要件が決まっていない。 製品として Excel なのか Google Sheets なのかが未定で、agent は推測するしかない。
- 正しさを証明する手段がない。 その処理にテストがなく、どんな変更も目で見て判断するしかない。
- 変更がもともと広範囲に及ぶ。 権限、決済、ログイン、削除、データ移行は、一か所を動かすと全体に響く。
こうした場合でも agent は役に立つ。用途を変えればいい。コードを読ませ、影響を受けるファイルを洗い出させ、テストの下書きを作らせ、二つのやり方の長所と短所を比べさせる。こうした成果物は main には入らず、間違っていても失うのは少しの時間だけだが、人が要件を早く固める助けになる。あの一行が書けるようになってから、実装を渡せばいい。
このルールにもコストはある。細かく分けるほど PR が増え、レビューの回数も増える。テストが十分にそろい、変更のパターンが繰り返しになる作業、たとえば依存パッケージの一括アップグレードや、決まったルールでの関数名の一括変更なら、まとめて渡したほうが効率がいい。Wu が agent に任せるのに最も向いていると言う、地味な保守作業の多くはこの種類だ。判断の基準は同じで、どう検証するかを言えるかどうかである。「全テストが通り、ビルドが成功し、挙動が変わらない」で一括アップグレードを証明できるなら、まとめて渡してよい。
AI も承認できるようになった後に、押さえておく三つの位置
Copilot の承認機能は現在パブリックプレビューで、初期設定ではオフになっている。管理者がエンタープライズ、組織、repo の単位で有効にでき、repo の管理者は Copilot が承認できるファイルパスを指定できる。有効にすれば、同じ repo の中に、人が一度も関わらない経路が生まれうる。agent が書き、AI が承認し、マージ条件が満たされる。
人を流れの中に残すには、三つの位置を押さえる。
- agent に実装させるパスでは、Copilot の承認を同時に有効にしない。 とくに権限、決済、データ移行に関わるディレクトリでは、承認は必ず人が行う。
- issue のテンプレートに「最初の diff」欄を加える。 この欄を埋められない issue は、自動的に「調査のみ」に回す。
- 一度に一歩ずつ進める。 最初の diff がマージされてから次の一歩を agent に任せ、どの一歩にも正しさを示すテストを付ける。スマートフォンから agent の次の一歩を承認することが多いなら、なおさらこの原則を守りたい。AI が書いたコードをスマホでマージする前に、リポジトリの規則に関所を任せるも参考になる。
細かく分けることには別の利点もある。一歩ごとのコンテキストが短くなり、失敗したときにやり直す範囲も小さくなるので、請求額が膨らみにくい。理由は長時間の AI タスクの費用は、再試行とコンテキストの読み直しに消えているで説明している。
次に agent に割り当てる issue には、まずあの一行を書き足してほしい。最初の diff はどこを変え、どのテストで証明するのか。書けるなら渡せばいい。書けないなら、その issue に必要なのは、まず人が要件を考え抜くことだ。
AI 整理カード
その issue を coding agent に渡せるか、AI と一緒に判断する このプロンプトは、まず issue の状況を確認し、単独でレビューできる最初の diff を書き出そうとする。書けない場合は、agent がいま取りかかれる調査作業を提案する。
ある issue を coding agent(たとえば Copilot coding agent や Devin)にそのまま実装させてよいか判断したい。
判断基準はこの記事による:https://boosterminiclass.com/ja/posts/coding-agents-need-human-checkpoints/
渡してよいのは、「単独でレビューできる最初の diff」を書き出せるタスクだけだ。つまり、どのファイルやモジュールを変えるのか、どのテストで正しさを証明するのかが言えること。

まず私に 3 つ質問してほしい:
1. この issue の完了条件は何か。まだ決まっていない製品上の判断はあるか;
2. 関連するコードには、いま挙動を証明できるテストがあるか;
3. 今回の変更は、権限、決済、ログイン、削除、データ移行に触れるか。

私の回答をもとに、次を出力してほしい:
- 一行の判断:そのまま渡す/先に分割してから渡す/agent には調査だけさせる;
- 渡せる場合:最初の diff の範囲と検証用テストを一文で書き、そのまま issue に貼れる形にする;
- まだ渡せない場合:三つの理由のどれで止まっているか、そして agent がいまできる調査作業(影響を受けるファイルの洗い出し、テストの下書き、二つのやり方の比較など)。
存在しないテストやコード構造を勝手に仮定しないこと。情報が足りなければ、続けて質問してほしい。
AI の提案は、問いを漏れなく立てる手助けにすぎない。渡すかどうかは、その repo に責任を持つ人が決める。
参考資料
- GitHub Changelog:Copilot code review can now approve pull requests — https://github.blog/changelog/2026-09-01-copilot-code-review-can-now-approve-pull-requests(2026-09-01)
- GitHub Docs:GitHub Copilot on GitHub.com — https://docs.github.com/en/copilot/concepts/agents/coding-agent/about-coding-agent [accessed: 2026-10-11]
- TechCrunch:Cognition’s Scott Wu says AI coding agents shouldn’t replace humans — https://techcrunch.com/2026/05/29/cognitions-scott-wu-says-ai-coding-agents-shouldnt-replace-humans/(2026-05-29)