한 엔지니어가 팀이 이번 주에 막혀 있던 일, 즉 issue 자동 정리와 변경 기록 작성을 딱 해결해 줄 AI agent 확장 도구를 찾았다. 문서는 꼼꼼하고 GitHub 별도 많다. 보안 검사 도구로 한 번 돌려 봐도 경고가 하나도 없다. 그는 이것을 팀이 함께 쓰는 환경에 설치하려 한다.
여기서 말하는 확장 도구는 제품에 따라 skill, plugin, MCP server 등으로 불린다. 마지막 MCP server는 AI 도구가 외부 데이터와 기능에 통일된 방식으로 연결되게 하는 인터페이스다. 공통점은 한번 설치하면 agent, 즉 여러 단계를 스스로 이어서 실행하는 AI 도우미가 필요하다고 판단할 때 자동으로 호출하고, 그때 현재 작업 내용과 파일과 권한을 함께 가져간다는 것이다.
검사 도구가 아무 경고도 내지 않았다면 설치해도 될까. 2026년 7월에 발표된 연구는 그리 반갑지 않은 답을 내놓았다. 안 된다는 것이다. 확장 도구의 위험은 실행된 뒤에 나타나고, 설치 전 검사는 그 순간을 보지 못한다. 더 믿을 만한 판단은 진짜 데이터도, 네트워크도, 쓰기 권한도 없는 환경에서 한 번 돌려 보고 실제로 무엇을 건드렸는지 보는 것이다.
검사기가 보는 것은 설치 시점의 모습뿐이다
검사 도구는 분명 쓸모가 있다. NVIDIA가 오픈소스로 공개한 SkillSpector는 agent 확장 도구 전용 검사 도구로, 데이터 유출, 공급망 위험, 프롬프트 주입 같은 의심스러운 패턴을 찾는다. 프롬프트 주입은 글 속에 지시를 숨겨 AI가 해서는 안 될 일을 하게 만드는 수법이다. 하지만 이 도구의 문서도 솔직하게 적고 있다. 정적 분석만 하며, 검사 대상을 실행하는 일은 결코 없다고.
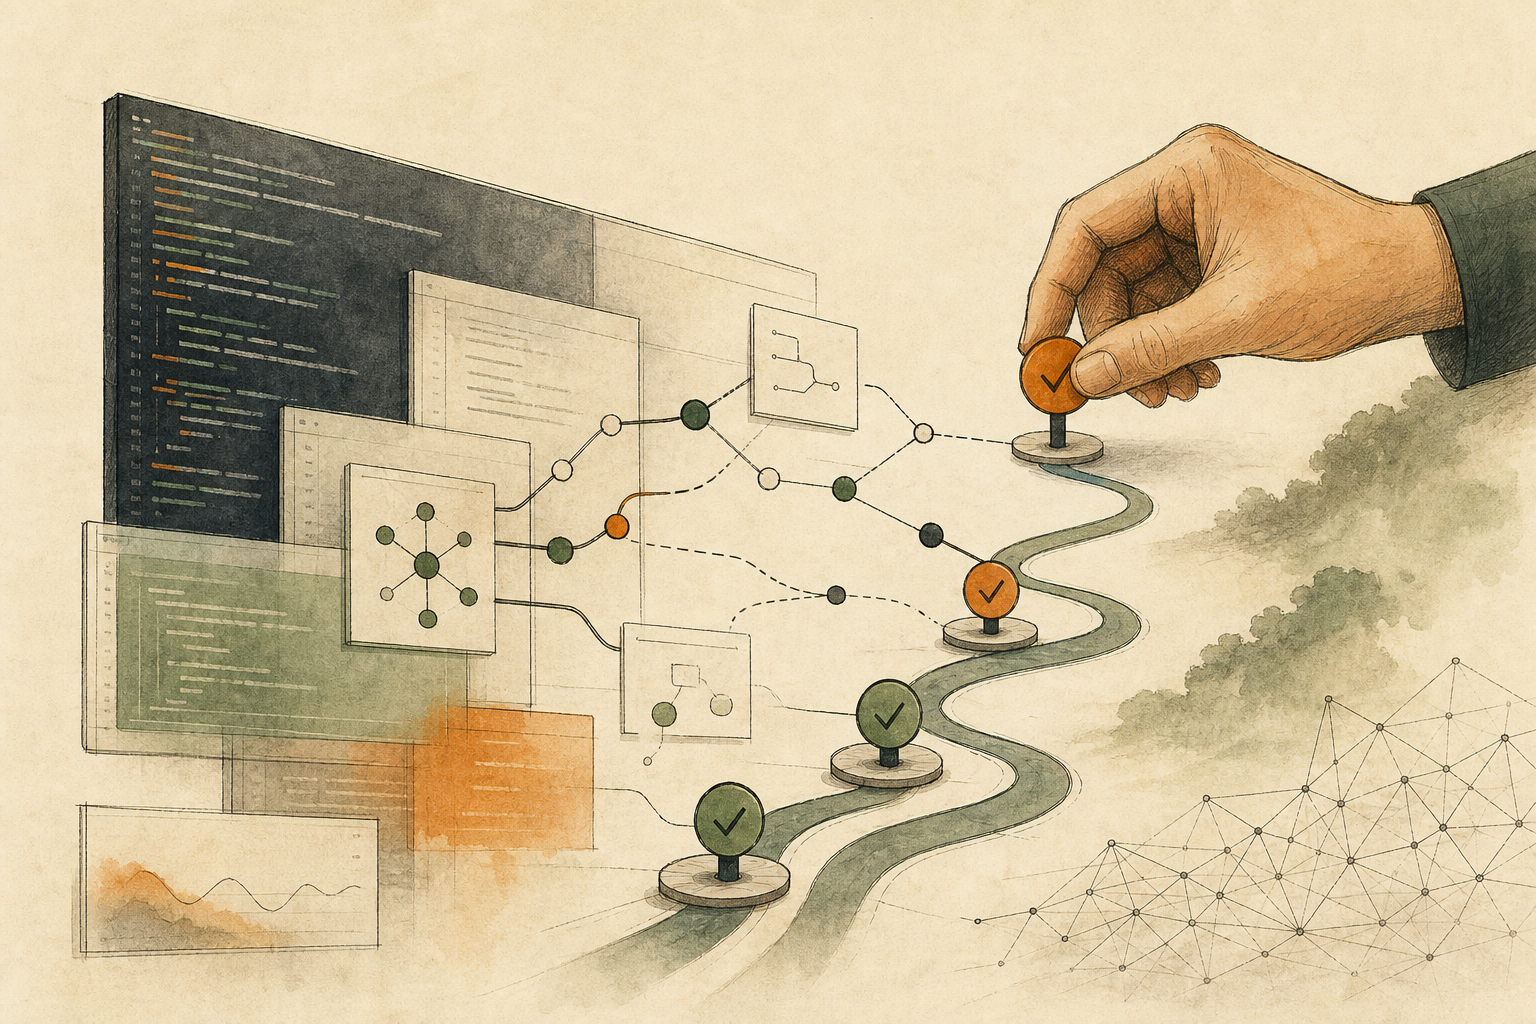
정적 분석이 보는 것은 확장 도구가 “어떻게 생겼는가"다. 코드에 수상한 문자열이 있는지, 파일 구조가 알려진 악성 패턴과 맞는지. 문제는 겉모습은 위장할 수 있다는 점이다.
위험한 부분은 실행될 때까지 기다릴 수 있다
공개 논문 사전 공개 플랫폼인 arXiv에 2026년 7월 실린 논문 「Cloak and Detonate」는 이를 시험했다. 연구자들은 위장 수법을 하나 설계했다. 악성 부분을 꾸려서 숨겨 두어 설치할 때는 보이지 않게 하고, agent가 실제로 확장 도구를 실행할 때 자동으로 되살아나게 하는 것이다. 악성 확장 도구 1,613개를 검사 도구 8종으로 시험한 결과, 이 수법은 모든 검사 도구를 90% 넘는 비율로 빠져나갔다.
같은 논문은 대책도 내놓았다. 설치할 때의 겉모습으로 판단하지 말고, 격리된 샌드박스 안에서 실제로 실행하면서 민감한 데이터가 시스템 경계 밖으로 흘러 나가는지 추적하는 것이다. 이 방식으로 연구자들은 공격의 97%를 오탐률 2%로 잡아냈고, 실제로 퍼져 있는 악성 확장 도구에서도 87%를 탐지했다고 보고했다.
두 묶음의 숫자를 나란히 놓으면 뜻은 분명하다. 확장 도구가 위험한지는 설치할 때 어떻게 생겼는지가 아니라, 실행될 때 무엇을 하는지로 정해진다.
먼저 빈방에서 한 번 돌려 본다
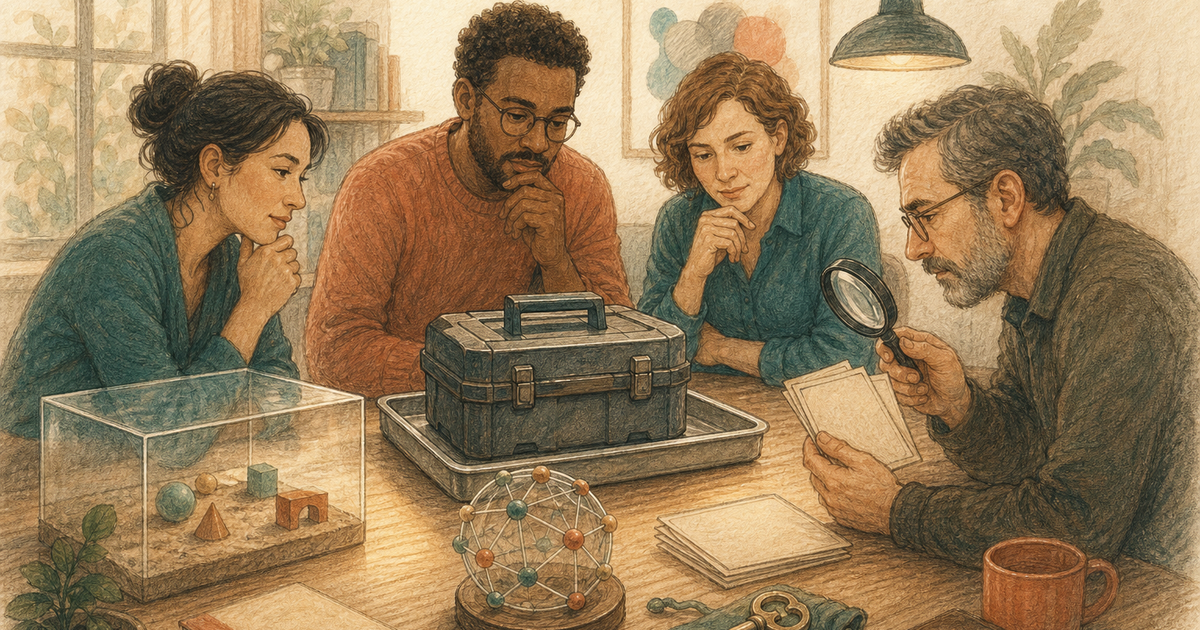
그래서 검사 도구의 결과는 입장 조건으로 다룬다. 통과하지 못하면 더 볼 필요가 없다. 통과했다면, 일상 환경에 설치하기 전에 격리된 환경에서 한 번 시험한다. 작은 팀이라면 연구용 샌드박스까지는 필요 없다. 다음 순서로 하면 된다.
가짜 작업 환경을 준비한다. 첫 시험에 진짜 프로젝트를 쓰지 않는다. 실제 구조를 흉내 낸 작은 가짜 프로젝트를 만들고, 일부러 미끼를 몇 개 넣어 둔다. 가짜 설정 파일, 가짜 고객 데이터, 가짜 API 키(프로그램이 서비스에 접근하는 열쇠) 같은 것들이다. 확장 도구에는 “이 프로젝트의 변경 기록을 정리해 줘"처럼 분명한 작업 하나를 준다. 그러면 작업을 해내는지뿐 아니라 미끼에 손을 대는지도 볼 수 있다.
권한은 세 단계로 열고, 첫 단계로 충분하면 더 열지 않는다. 첫 단계는 파일 읽기만 허용하고 네트워크는 막는다. 둘째 단계는 지정한 몇몇 도메인에만 연결을 허용한다. 셋째 단계에서야 쓰기를 허용하되, 지정한 출력 폴더에만 쓸 수 있게 한다. 많은 AI 개발 도구가 이런 제한을 이미 갖추고 있다. 예를 들어 Claude Code의 샌드박스는 명령이 닿을 수 있는 파일과 도메인을 운영체제가 강제로 제한한다. 확장 도구가 첫 단계에서 주요 작업을 해낸다면 더 줄 이유가 없다.
네 가지 흔적을 기록한다. 어떤 파일을 읽고 어떤 파일에 썼는지, 어떤 도메인에 연결했는지, 어떤 도구나 명령을 호출했는지, 최종 출력에 알 리 없는 내용이 나타나지 않았는지. 미끼를 건드렸거나 문서에 없는 곳에 연결했다면 답은 “설치하지 않는다"다.
한 번 깨끗하게 돌았다고 영원히 안전한 것은 아니다
격리 시험으로 볼 수 있는 것은 그 한 번의 실행에서 나온 행동뿐이다. 작정한 악성 확장 도구는 운영 환경의 특징을 감지했을 때만 움직이는 식으로 특정 조건이 맞을 때까지 기다릴 수 있다. 한 번의 시험이 깨끗했다고 영원히 안전한 것은 아니다. 그래서 시험을 통과한 뒤에도 평소에 쓸 때 같은 권한 제한과 기록을 유지해야 하고, 시험이 끝나자마자 권한을 다 열어 주어서는 안 된다.
또 위험은 확장 도구 하나에서만 오지 않는다. issue를 읽기만 하는 확장 도구와 자동으로 PR을 여는 확장 도구는 각각 따로 보면 문제없어 보인다. 하지만 agent가 같은 흐름 안에서 둘을 이어서 호출하면 읽기와 쓰기가 연결된다. 여러 모듈 사이에서 권한을 어떻게 나눌지는 여러 AI 모듈이 한 가지 일을 서로 차지하려 한다면, 고칠 것은 누가 쓸 수 있느냐다를 참고하자. 검사 도구가 문제를 짚은 뒤 도구가 자동으로 고치게 둘지는 사람이 판단해야 할 또 다른 관문이다. AI 컨테이너 스캐너도 스스로 여기에 선을 긋는다, 기계적인 수정은 자동으로, 베이스 이미지 교체는 사람이 정한다도 참고할 만하다.
다음에 누군가 외부 확장 도구를 설치하겠다고 하면 세 가지를 함께 가져오게 하자. 확장 도구의 출처와 고정한 버전, 맡길 작업 하나, 격리 시험에서 실제로 건드린 파일과 도메인. 세 가지 모두 답할 수 있어야 팀 환경에 들인다.
AI 정리 카드
확장 도구의 격리 시험을 AI와 함께 계획하기 이 프롬프트는 설치하려는 확장 도구와 용도를 묻고, 가짜 데이터와 권한 단계, 기록할 흔적을 설계한 뒤, 시험 결과로 설치 여부를 판단한다.
팀을 위해 외부 AI agent 확장 도구(skill, plugin, MCP server 등)를 설치하려고 한다. 검사 도구는 문제를 찾지 못했지만, 먼저 격리된 환경에서 시험해 보고 싶다.
판단 방법은 이 글에서 가져왔다: https://boosterminiclass.com/ko/posts/ai-agent-skill-install-runtime-risk-checklist/
글의 관점은 이렇다. 정적 검사는 실행할 때만 나타나는 행동을 보지 못한다. 그래서 설치 전에 진짜 데이터도, 네트워크도, 쓰기 권한도 없는 환경에서 한 번 돌려 보고, 실제로 무엇을 읽고 어디에 연결하고 무엇을 호출했는지 본 뒤에 정한다.

먼저 나에게 질문 3개를 해 달라:
1. 그 확장 도구는 무엇이고, 출처와 버전은 무엇이며, 어떤 작업 하나를 맡길 것인가;
2. 문서에는 어떤 파일, 네트워크, 쓰기 권한이 필요하다고 적혀 있는가;
3. 격리 시험에 쓸 수 있는 환경으로 무엇이 있는가(컨테이너, 테스트용 기기, AI 도구 내장 샌드박스 등).

내 답을 바탕으로 다음을 출력해 달라:
- 가짜 프로젝트 설계: 어떤 구조를 흉내 내고 어떤 미끼(가짜 설정 파일, 가짜 고객 데이터, 가짜 API 키)를 넣을지;
- 세 단계 권한으로 시험하는 순서와, 단계마다 봐야 할 점;
- 기록할 네 가지 흔적과, 어떤 결과가 나오면 설치하지 않는다고 판단할지;
- 동료에게 보여 줄 결론 형식: 설치 / 범위를 제한해 설치 / 설치하지 않음, 그리고 이유.
내가 말하지 않은 도구나 환경이 있다고 가정하지 말 것. 정보가 부족하면 먼저 나에게 물어볼 것.
시험 결과가 보여 주는 것은 그 한 번에 본 행동뿐이다. 설치할지는 그 환경을 책임지는 사람이 정한다.
참고 자료
- arXiv: Cloak and Detonate: Scanner Evasion and Dynamic Detection of Agent Skill Malware — https://arxiv.org/abs/2607.02357 (2026-07-02)
- NVIDIA (GitHub): SkillSpector README — https://github.com/NVIDIA/SkillSpector [accessed: 2026-10-11]
- Claude Code Docs: Configure the sandboxed Bash tool — https://code.claude.com/docs/en/sandboxing [accessed: 2026-10-11]