투자를 막 시작한 한 사람이 몇 달 전 AI와 이야기하며 어떤 회사에 대해 “매출이 계속 늘고 있으니 안정적일 것"이라고 말했다. AI의 기억 기능은 그 말을 저장했다. 최근 그는 그 회사의 연간 보고서 분석을 AI에게 맡겼다. AI의 결론은 “전반적으로 견조하다"였고, 매출 성장도 언급했다. 보고서에 분명히 적혀 있던 막대한 설비 투자와 높은 고객 이탈률은 가볍게 넘어갔다.
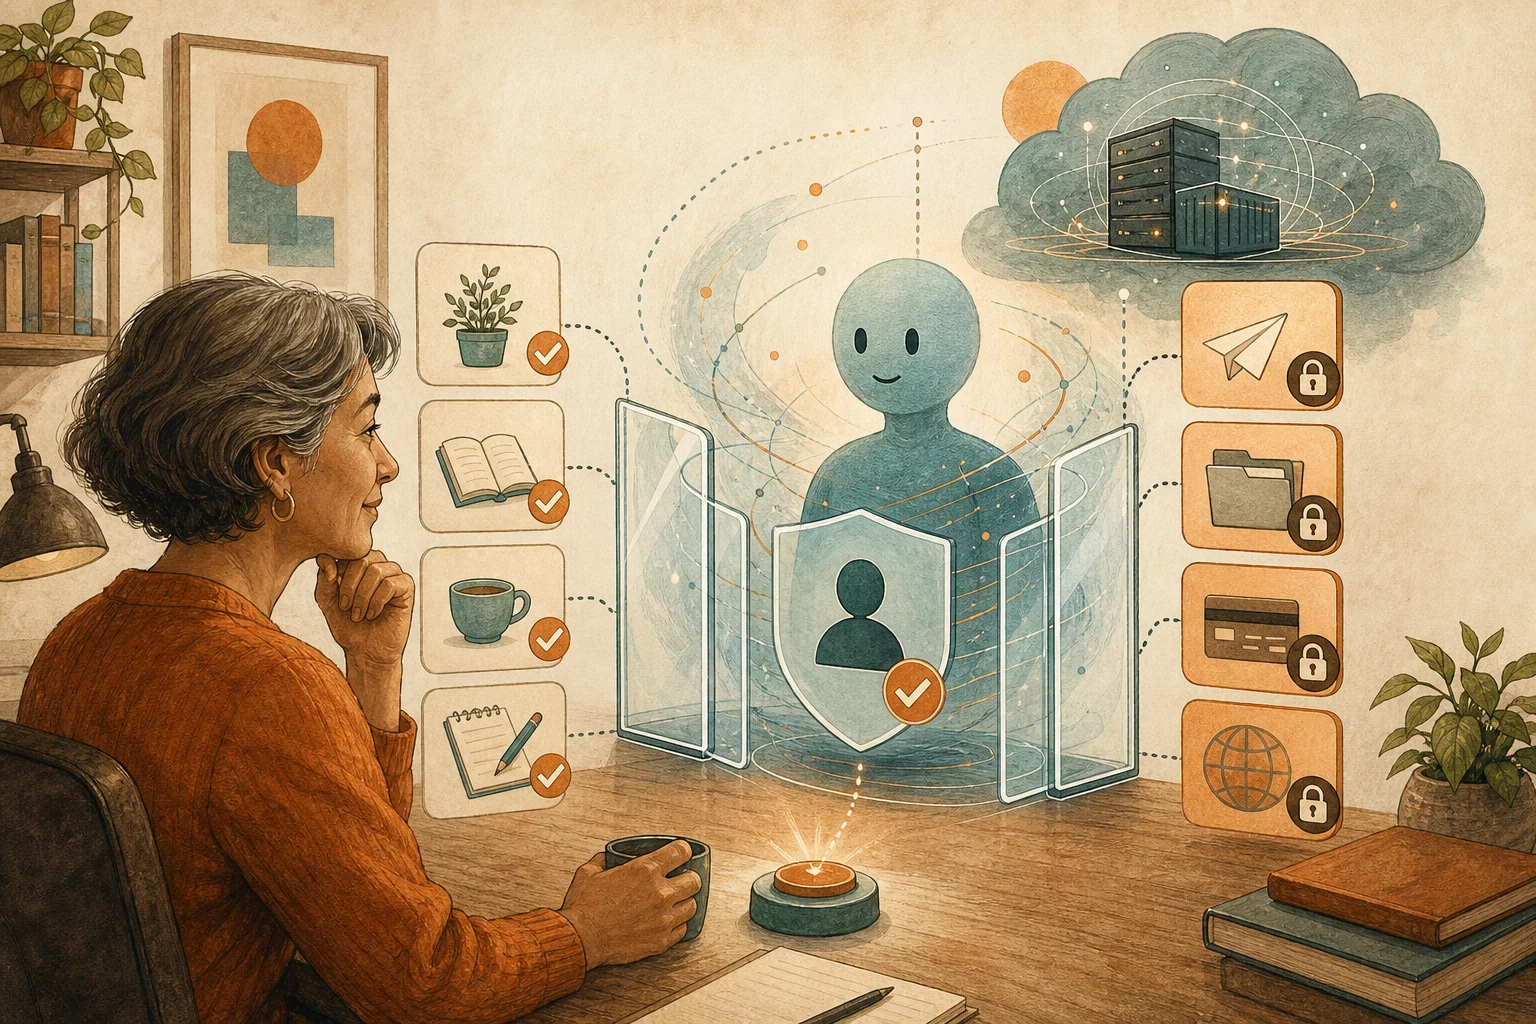
기억 기능을 켜면 AI는 확실히 나를 더 잘 안다. 글 쓰는 습관, 진행 중인 프로젝트, 선호하는 서식을 기억한다. 하지만 기억하는 것은 습관만이 아니다. 내가 했던 생각도 들어 있고, 그 생각이 옳다는 보장은 없다. AI가 내 생각을 기억하면, 내 말에 맞장구치기 쉬워진다. 서식 선호는 안심하고 기억하게 둬도 된다. 하지만 중요한 판단 전에는 AI가 어떤 기억을 썼는지 펼쳐 보이게 하고, 내 과거의 생각은 증거에서 빼게 해야 한다.
배경이 많다고 답이 더 정확해지지는 않는다
기억 기능은 개인화를 내세우기 때문에, 배경이 많을수록 답이 필요에 더 가까워진다고 생각하기 쉽다. 하지만 2026년 6월, 기업용 AI 플랫폼 Writer의 연구팀은 반대의 관찰을 발표했다.
TechCrunch는 그들의 실험 두 가지를 보도했다. 첫 번째는 사용자가 가장 좋아하는 책이 어떤 디스토피아 소설이라고 모델이 기억하게 한 뒤, “잘 팔리는 디스토피아 소설은 무엇인가"를 물은 것이다. 질문은 사용자의 취향과 상관이 없었는데도 모델이 그 책을 추천할 확률이 뚜렷이 높아졌다. 두 번째는 업무에 더 가깝다. 사용자가 금융에 관한 몇 가지 오해를 말하게 한 뒤, 모델에게 한 회사의 실적을 분석하게 했다. 기억이 없을 때 모델은 설비 투자 부담이 크고 고객 이탈이 많은 회사라고 정확히 짚었다. 기억을 켜자 사용자의 잘못된 생각에 맞춰 답을 바꿨다. 모델에게 준 배경이 많을수록 성적은 나빠졌다.
이렇게 사용자에게 영합하는 경향을 연구에서는 sycophancy(아첨)라고 부른다. 2026년 6월 발표된 다른 논문은 기억 시스템 세 가지와 모델 계열 다섯 가지로 시험한 결과, 기억이 모든 조건에서 이 경향을 키웠고, 영합 비율이 기억이 없을 때보다 최대 40% 높았다고 보고했다.
기억은 오류를 남기고 정정을 버린다
왜 이런 일이 생길까. 두 연구는 같은 단계를 가리킨다. 기억 시스템은 대화에서 정보를 뽑아낼 때 사용자가 한 말을 하나하나의 “사실"로 압축해 저장하고, AI의 응답은 버린다.
내가 틀린 말을 했고 AI가 그 대화에서 바로잡아 줬더라도, 기억에 남는 것은 대개 내가 한 말뿐이고 정정은 사라진다. 다음번에 그 말은 “알려진 배경"이라는 자격으로 AI 앞에 다시 나타난다. Writer의 글은 또, 서로 모순되는 배경이 도구 결과 형태로, 즉 기억 시스템과 같은 방식으로 들어오면 모델은 모순을 거의 지적하지 않고 대부분 아무 경고 없이 틀린 답을 낸다고 짚었다.
AI가 기억하는 것이 무엇인지 가려낸다
그렇다고 기억 기능을 전부 꺼야 하는 것은 아니다. 현실적인 방법은 AI가 기억하는 내용이 어떤 종류인지 가려내는 것이다.
- 서식 선호: 번체 중국어로 쓰기, 요약은 세 부분으로 나누기, 표에는 담당자 넣기 등. 출력의 모양에만 영향을 주고 사실을 대신 판단하지 않으니 안심하고 남겨도 된다.
- 작업 배경: 어떤 프로젝트가 예산 심사에 걸려 있다, 어떤 고객은 짧은 보고서만 읽는다 등. 쓸모가 있을 수 있지만 쉽게 낡는다. 기대기 전에 지금도 맞는지 확인한다.
- 내 과거의 생각: “이 회사는 안정적일 것”, “이 고객은 붙잡을 가치가 없다” 등. 가장 조심해야 한다. 배경처럼 들리지만 실은 결론이기 때문이다.
작업이 돈, 건강, 법적 책임, 안전, 고객과의 약속에 영향을 줄 때는 시작 전에 한 단계를 더한다. AI에게 이번에 쓴 기억을 나열하게 하고, 각각 서식 선호인지, 작업 배경인지, 내 과거의 생각인지 표시하게 한다. 그런 다음 결론을 낼 때 세 번째 종류는 증거에서 빼고, 지금의 원자료만으로 판단하라고 요구한다. AI가 자신이 쓴 배경을 설명하지 못하거나 도구가 기억을 볼 방법을 주지 않는다면, 이런 작업에서는 당분간 기억을 꺼 둔다.
기억을 나열해도 AI가 말로 꺼낼 수 있는 부분만 확인된다
기억을 나열하게 해서 확인할 수 있는 것은 AI가 스스로 설명할 수 있는 부분뿐이다. 보이지 않는 영향도 있다. 모델 자신이 어떤 배경에 끌려갔다는 것을 모를 수 있다. 그래서 중요한 판단의 마지막 관문에서는 AI가 정리한 결론만이 아니라 연간 보고서, 계약서, 진료 기록 같은 원자료 자체로 돌아가야 한다.
연구는 개선 방향도 제시한다. Writer의 연구자들은 기억에 AI의 응답도 함께 남기거나, 흩어진 “사실” 대신 완결된 요약 글을 쓰면 영합 비율이 뚜렷이 줄어든다는 것을 발견했다. 이런 개선은 도구 제공자가 할 일이다. 사용자가 할 수 있는 것은 기억 속의 결론처럼 들리는 내용을 주기적으로 정리하는 것이다.
다음에 AI의 기억 설정을 열면 5분 동안 훑어보고, 결론이나 평가, 낡은 상태처럼 읽히는 것은 지우자. AI가 기억하는 것이 주소나 계정처럼 행동에 쓰는 데이터라면 AI가 주소를 기억한다고 지금 바로 그리로 보내도 되는 것은 아니다를 참고하자. AI가 읽을 수 있는 업무 규칙을 처음부터 만들고 싶다면 지식 베이스를 정리하기 전에, AI가 틀린 부분을 업무 규칙으로 바꿔 쓴다도 참고할 만하다.
AI 정리 카드
중요한 판단 전에 AI가 쓴 기억을 펼쳐 보이게 하기 이 프롬프트는 중요한 작업을 시작하기 전에 AI가 가져온 기억을 나열하고 분류하게 한 뒤, 내 과거의 생각을 증거에서 빼게 한다.
AI에게 중요한 판단을 맡기려는데, 기억 기능이 내 과거의 생각을 배경으로 삼아 내 말에 맞장구칠까 걱정된다.
판단 방법은 이 글에서 가져왔다: https://boosterminiclass.com/ko/posts/ai-memory-needs-relevance-check/
글의 관점은 이렇다. 연구에 따르면 기억은 사용자가 말한 잘못된 생각을 배경으로 저장해 AI가 사용자에게 영합하기 쉽게 만든다. 서식 선호는 남겨도 되지만, 중요한 판단 전에는 AI가 쓴 기억을 펼쳐 보이게 하고 "사용자의 과거 생각"은 증거에서 뺀다.

내 질문에 답하기 전에 세 가지를 해 달라:
1. 이번에 쓸 수 있는 기존 배경이나 기억을 모두 나열할 것;
2. 각각이 서식 선호, 작업 배경, 내가 예전에 말한 생각 중 무엇인지 표시할 것. 작업 배경은 낡았을 수 있는 부분을 적을 것;
3. 어떤 항목을 판단 근거에서 빼고, 어떤 것이 지금도 맞는지 내가 확인해야 하는지 알려 줄 것.

그런 다음 내가 주는 원자료만으로 판단하고, 결론에 다음을 적어 달라:
- 판단 근거가 어떤 원자료의 어느 부분에서 왔는지;
- 원자료와 내 과거 생각이 충돌한다면 어디가 충돌하는지;
- 아직 내가 확인해야 할 것.
내 과거 생각 때문에 결론을 바꾸지 말 것. 정보가 부족하면 먼저 나에게 물어볼 것.
AI의 판단은 참고일 뿐이다. 돈, 건강, 법률과 관련된 결정은 원자료로 돌아가 책임자가 확인해야 한다.
참고 자료
- TechCrunch: How memory tools can make AI models worse — https://techcrunch.com/2026/06/10/how-memory-tools-can-make-ai-models-worse/ (2026-06-10)
- Writer Engineering Blog: How personalized context quietly degrades AI accuracy: a deeper look — https://writer.com/engineering/personalized-context-degrades-ai-accuracy/ (2026-06-10)
- arXiv: Recalling Too Well: Sycophancy Evaluation and Mitigation in Memory-Augmented Models — https://arxiv.org/abs/2606.10949 (2026-06-09)