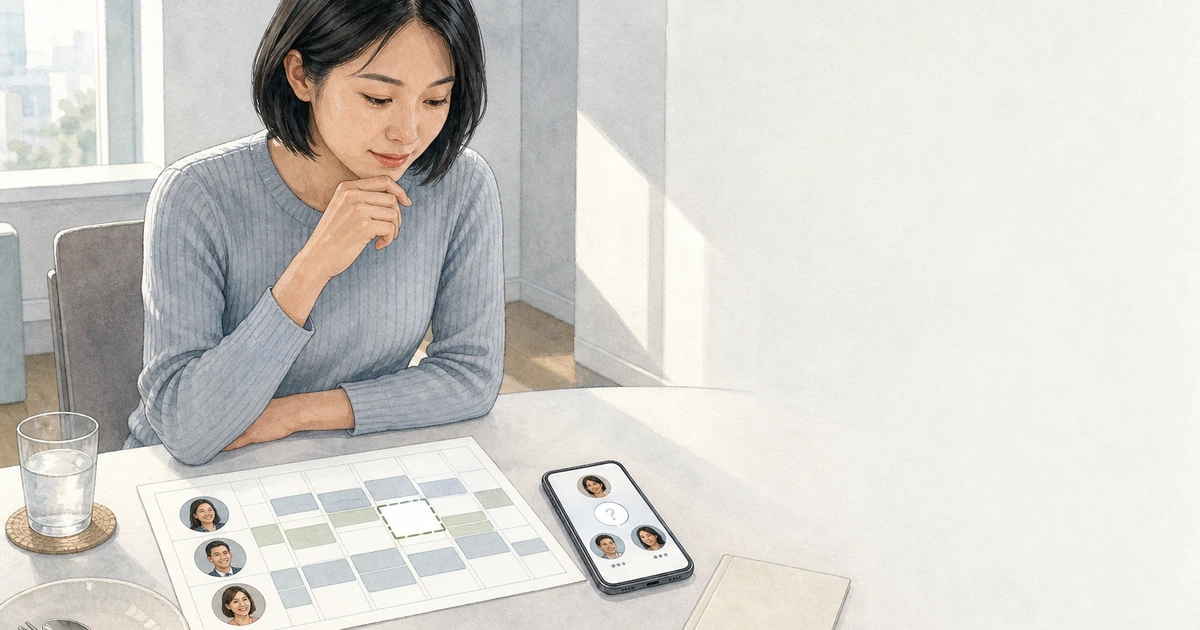
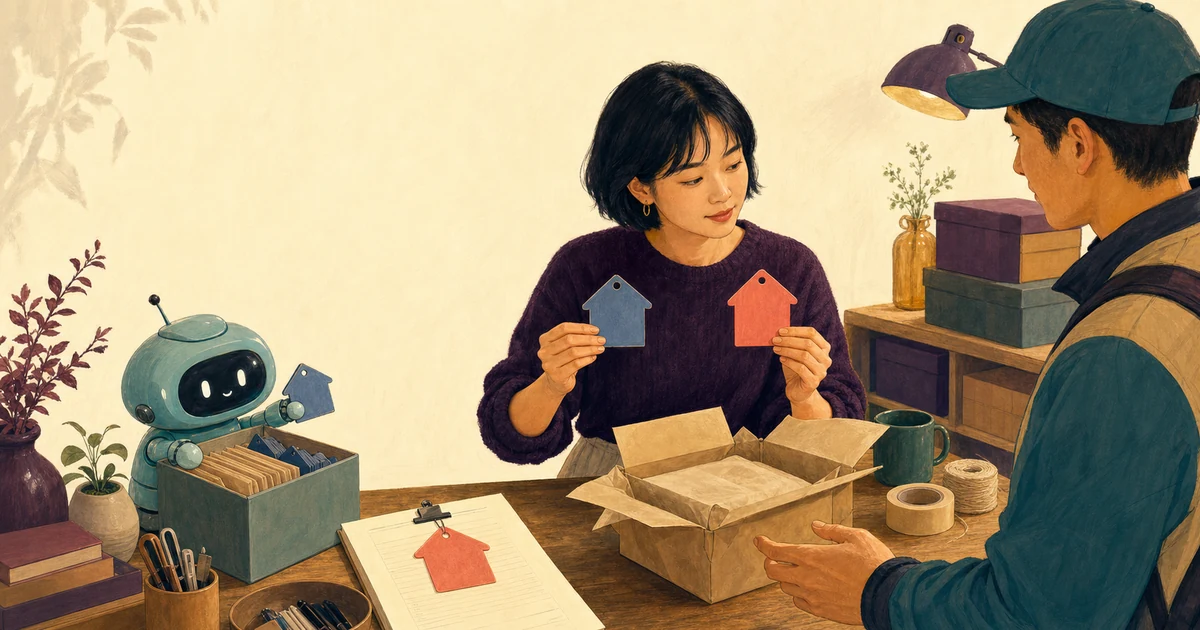
작은 온라인 쇼핑몰에서 일하는 린 씨는 단골손님에게 보낼 택배 준비를 AI 비서에게 맡겼다. AI는 지난 대화에서 그 손님의 주소를 찾아냈다. 형식도 완벽하고 말투도 자연스러웠으며, 다시 입력하는 수고도 덜었다. 문제는 손님이 이번 주문에는 새집 주소를 적었는데, AI가 쓴 것은 반년 전 대화에서 나온 예전 회사 주소였다는 점이다.
“AI가 기억하는 주소가 그럴듯한가"만 묻는다면 답은 아마 “그렇다"일 것이다. 정말 물어야 할 것은 이 상자가 어디로 갈지 무엇이 정하느냐다. 답은 이번 주문의 배송지 칸이지, AI의 기억이 아니다. 그래서 주소, 금액, 예약 시간처럼 행동에 쓰는 데이터에 대해 AI 기억이 할 수 있는 일은 “여기에 주소가 필요하다"고 알리는 것뿐이다. 값 자체는 행동 직전에 그것을 갱신할 책임이 있는 원본에서 다시 읽는다. 둘이 맞지 않으면 멈춘다.
기억한다고 지금도 맞는 것은 아니다
기억 기능 덕분에 AI가 많은 질문을 건너뛰니, 기억하는 내용은 믿을 만하다고 생각하기 쉽다. 하지만 기억이 증명할 수 있는 것은 어떤 정보가 한때 대화에 나왔다는 사실뿐, 지금도 유효하다는 것은 아니다. 사람은 이사하고, 담당자는 바뀌고, 예산은 다시 승인된다. 기억 속 값은 저절로 따라 갱신되지 않는다.
같은 대화에서 “주소 정말 맞아?“라고 다시 물어도 소용없다. AI는 같은 기억에서 답을 찾으니, 기억이 스스로를 증언하는 셈이다. 제대로 확인하려면 다른 길로 가야 한다. 다른 누군가가 책임지고 관리하는 데이터로 돌아가는 것이다.
데이터 종류마다 원본을 정한다
같은 “기억해 줘” 뒤에도 네 가지 다른 보관 요구가 있을 수 있고, 두어야 할 곳이 각각 다르다.
- 답변 선호: 목록형을 좋아한다, 요리법에 고수를 넣지 않는다 등. 기억에 남겨도 되고 내용 조정에만 쓴다. 틀려도 고치기 쉽다.
- 이번 거래의 값: 배송지, 결제 금액, 예약 시간 등. 이번 주문, 청구서, 예약 기록에 둔다. 어떤 거래를 하든 그 거래의 기록을 읽는다.
- 계속 바뀌는 업무 데이터: 고객 담당자, 재고, 기한, 승인된 예산 등. 고객 관리 시스템, 재고 시스템, 캘린더, 승인 기록으로 돌려보내고, 누가 갱신하는지와 마지막 갱신 시점도 남긴다.
- 민감하거나 제3자에 관한 데이터: 건강 정보, 다른 사람의 연락처, 동의 기록 등. 용도, 권한, 보관 기간이 이미 정해진 시스템에만 둔다. 그런 곳이 없다면 그때그때 권한 있는 사람에게 확인하고, AI 기억에 따로 저장하지 않는다.
어떤 데이터가 원본이 될 수 있는지는 그것이 이 항목, 이 상대, 이 시점을 책임지느냐로 정해진다. 오래된 상담 대화보다 이번 주문이 배송지를 정하기에 더 알맞고, 대화 속 “그날은 될 것 같아요"보다 확정된 캘린더가 회의 시간을 정하기에 더 알맞다.
행동하기 전에 원본에서 다시 읽는다
발송이라면 올바른 순서는 이렇다. AI는 기억에서 “이 흐름에는 배송지가 필요하다"는 것을 안다. 이어서 주문 번호로 이번 주문의 배송지를 읽기 전용으로 읽어 온다. 미리 보기에는 그 주소와, 어디서 왔는지, 언제 읽었는지를 함께 보여 준다. 사람이 확인한 뒤에야 발송이 실행된다. 발송을 맡은 프로그램 부분은 기억에서 바로 온 주소를 받아들이지 않게 해 둔다.
같은 방식은 다른 동작에도 적용된다. 예약 전에는 지금의 캘린더를, 결제 전에는 승인된 청구서를, 알림 전에는 해당 건의 연락처 목록을 읽는다.
다시 읽은 결과에도 멈춤 조건이 필요하다. 기록을 찾을 수 없거나, 권한이 없거나, 데이터 버전이 너무 오래됐거나, 기억 속 값과 원본이 다르거나, 원본 자체가 아직 “확인 필요"로 표시돼 있다면, 낼 수 있는 것은 초안과 사람에게 확인할 질문뿐이다. AI가 어느 쪽이 더 최신인지 추측해서는 안 되고, 사용자의 일회성 답변을 슬그머니 영구 기본값으로 저장해서도 안 된다.
이는 두 기술 문서의 당부와도 맞는다. Anthropic이 개발자에게 제공하는 기억 도구는 데이터를 어디에 어떻게 저장하고 읽고 쓸지를 애플리케이션 스스로 정하게 하고, 개발자에게 민감한 데이터 처리와 오래 쓰지 않은 기억의 주기적 삭제를 요구한다. 애플리케이션 보안을 다루는 개방형 커뮤니티 OWASP의 AI 에이전트 보안 지침은 영향이 큰 동작의 승인을 구체적인 도구, 대상, 매개변수에 묶으라고 요구한다. 기억은 관리해야 할 데이터이고, 모델이 자신 있어 보인다고 저절로 정확하게 유지되지 않는다.
원본이 없을 때
행동할 때마다 원본에서 다시 읽으려면 원본이 존재하고 읽을 수 있어야 한다. 작은 팀 상당수는 고객 데이터가 스프레드시트, 메일, 채팅 기록에 흩어져 있어 분명한 원본이 없다. 이럴 때 첫걸음은 AI와 무관하다. 가장 자주 쓰는 몇 가지 항목, 예를 들어 배송지에 대해 갱신을 책임질 곳을 정하는 것이다.
틀린 데이터를 고칠 때는 순서도 중요하다. 먼저 원본을 고치고, 그다음 기억을 지운다. 주소가 틀렸다는 것을 안 린 씨는 먼저 이번 주문을 고쳐야 한다. 고객 정보의 기본 주소도 낡았다면 권한 있는 사람이 갱신한다. AI의 기억과 옛 대화를 정리하는 것은 그다음이다. 원본은 그대로 두고 기억만 지우면, 다음에 AI가 다른 곳에서 또 옛 주소를 읽을 수 있다.
다음 단계로, 매일 실제로 돌아가는 발송, 예약, 알림 흐름 하나를 골라, 행동에 쓰이는 항목마다 원본이 어디 있고, 무엇으로 조회하고, 누가 갱신하는지 적어 보자. 설명할 수 없는 항목이 있다면 그 흐름은 초안 단계에 둔다. AI가 기억하는 것이 데이터가 아니라 내 과거의 생각이라면, 걱정해야 할 것은 다른 문제다. AI가 내 생각을 기억하면, 내 말에 맞장구치기 쉬워진다를 참고하자. 자주 쓰는 데이터의 원본을 정하는 방법은 AI에게 회사 숫자를 묻게 할 때, 정확도는 정의를 관리하는 사람이 있느냐에 달렸다도 참고할 만하다.
AI 정리 카드
발송, 예약, 결제, 알림을 하는 AI 흐름이 AI 기억 속 오래된 데이터를 그대로 써서 움직이지 않는지 확인하고 싶다.
판단 방법은 이 글에서 가져왔다: https://boosterminiclass.com/ko/posts/ai-memory-verify-before-action/
글의 관점은 이렇다. 행동에 쓰는 데이터(주소, 금액, 예약 시간, 연락처)에 대해 AI 기억이 할 수 있는 일은 "무엇이 필요한지" 알리는 것뿐이고, 값 자체는 행동 직전에 갱신 책임이 있는 원본(예: 이번 주문)에서 다시 읽는다. 원본이 없거나, 권한이 없거나, 값이 다르면 미리 보기 단계에서 멈춘다.

먼저 나에게 질문 3개를 해 달라:
1. 어떤 흐름이고, 마지막에 어떤 동작(발송, 예약, 결제, 알림)을 하는가;
2. 그 동작에 쓰이는 항목은 무엇이고, 지금 AI는 그것을 어디서 가져오는가;
3. 그 데이터는 평소 어떤 시스템에 있고, 누가 갱신하는가.

내 답을 바탕으로 다음을 출력해 달라:
- 항목마다 한 줄: 지금의 획득 방식 / 읽어야 할 원본 / 조회 기준(주문 번호 등) / 갱신 담당자. 모르는 것은 "확인 필요"로 표시;
- AI가 실행 전에 어떻게 다시 읽고 대조해야 하는지, 미리 보기에 무엇을 보여야 하는지;
- 초안에서 멈춰야 하는 경우: 원본 없음, 권한 없음, 버전이 너무 오래됨, 값이 다름;
- 데이터가 틀렸을 때 고치는 순서: 먼저 어디를 고치고, 그다음 무엇을 지울지.
점검과 제안만 하고, 나 대신 데이터나 기억을 바꾸지 말 것. 실행 여부는 그 흐름을 책임지는 사람이 정한다.
참고 자료
- Anthropic (Claude Platform Docs): Memory tool — https://platform.claude.com/docs/en/agents-and-tools/tool-use/memory-tool [accessed: 2026-10-11]
- OWASP Cheat Sheet Series: AI Agent Security Cheat Sheet — https://cheatsheetseries.owasp.org/cheatsheets/AI_Agent_Security_Cheat_Sheet.html [accessed: 2026-10-11]
- OpenAI Help Center: Memory FAQ — https://help.openai.com/en/articles/8590148-memory-faq [accessed: 2026-10-11]