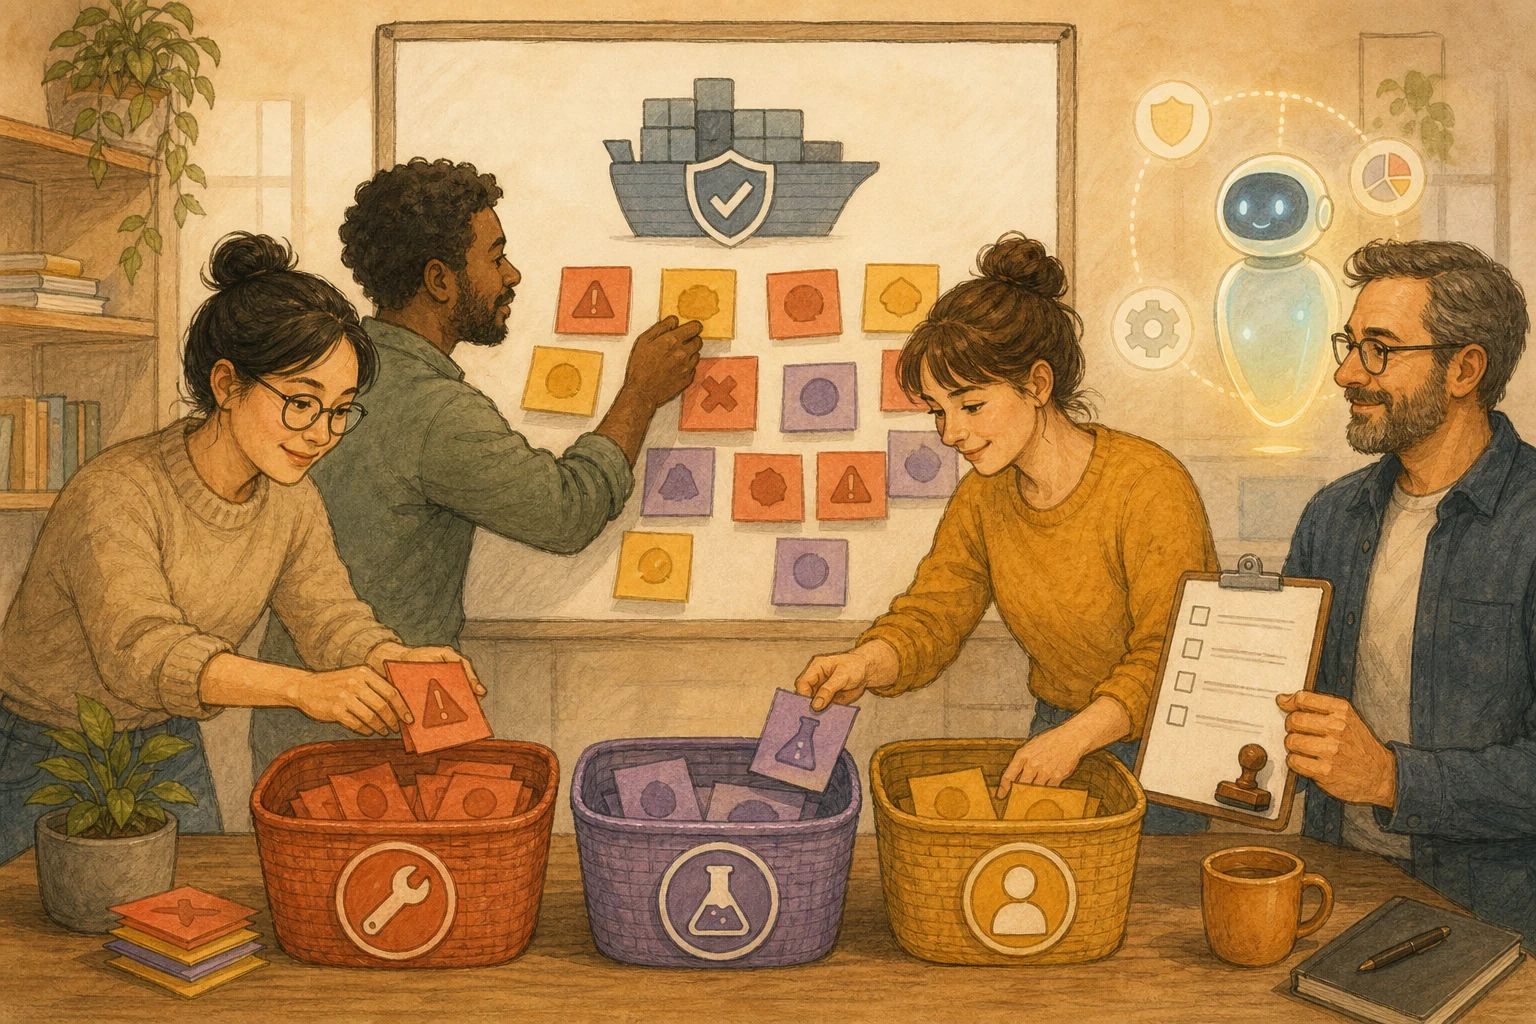
보안 스캔이 한 번에 경고 300건을 보내왔다. 가장 손쉬운 방법은 점수가 높은 것부터 내려가며 처리하는 것이다. 그런데 1위인 9.8점이 테스트할 때만 쓰고 실제 서비스에는 들어가지도 않는 패키지에 있다면 어떨까. 반면 백몇 번째쯤의 6.5점은 사용자가 올린 이미지를 처리하는 라이브러리에 있고, 공개 웹사이트의 업로드 기능 바로 뒤에 있으며, 이미 “악용이 확인된” 목록에 올라 있다. 점수대로 줄을 세우면 정말 급한 한 건이 목록 한가운데에 며칠씩 묻힌다.
스캔 점수가 재는 것은 취약점 자체가 얼마나 심각한지이지, 내 시스템 안에서 얼마나 급한지가 아니다. 순서를 정할 때는 세 가지를 차례로 묻는다. 밖에서 이미 누군가 악용하고 있는가. 내 서비스가 실제로 그 코드를 실행하는가. 외부 입력이 거기까지 닿는가. AI는 경고마다 이 세 가지 증거를 정리할 수 있지만, 어떤 경고를 닫아도 되는지 정하는 것은 여전히 사람의 책임이다.
점수는 “맞으면 얼마나 심한가"를 말할 뿐 “맞을 것인가"는 말하지 않는다
대부분의 스캔 도구가 내는 점수는 CVSS(공통 취약점 점수 체계)에서 나오며, 보안 사고 대응팀들의 국제 협의체 FIRST가 관리한다. FIRST의 공식 규격은 분명히 적고 있다. 이 점수는 한 취약점이 다른 취약점에 비해 얼마나 심각한지를 나타낸다. 자기 조직에 대한 위험을 평가하려면 점수 밖에 사용자 자신의 상황을 더해야 한다.
다시 말해 9.8점이 말하는 것은 “맞으면 결과가 심각하다"이지 “당신이 맞는다"가 아니다. 같은 취약점이라도 실행되지 않는 테스트 패키지에 있을 때와 공개 입구 뒤에 있을 때 긴급도는 완전히 다른데, 점수는 똑같다.
세 가지 질문에 차례로 답한다
첫째, 밖에서 이미 악용되고 있는가. 미국 사이버보안·기반시설안보청(CISA)은 “악용이 확인된 취약점 목록”(KEV)을 관리한다. 실제 공격에서 악용이 확인된 취약점을 싣고, 조직들에게 수정 우선순위를 정하는 근거 중 하나로 쓰라고 권한다. 이 목록에 오른 취약점은 다른 증거가 다 모이기를 기다리지 않고 대응 수준을 올려도 된다.
둘째, 내 서비스가 그 코드를 실행하는가. 취약한 패키지가 의존성 목록에 있다고 해서 서비스가 실행 중에 문제의 함수를 부른다는 뜻은 아니다. 개발이나 테스트 단계에서만 쓰는 패키지, 호출되지 않는 모듈은 실행 경로에 닿지 않으므로 긴급도가 훨씬 낮다. 이것은 패키지 목록만이 아니라 코드와 실제 실행 기록을 봐야 판단할 수 있다.
셋째, 외부 입력이 거기까지 닿는가. 실행된다는 것만으로는 부족하고, 누가 그 코드에 데이터를 보낼 수 있는지도 봐야 한다. 공개 웹사이트 방문자, 권한이 낮은 계정, 업로드된 파일은 모두 외부 입력이다. 내부의 고정된 설정 파일만 읽는 코드라면 악용될 기회는 훨씬 작다.
세 질문 모두 “예"라면 맨 앞에 둔다. 답하지 못한 것은 “검증 필요"로 적고, 누가 어떤 방법으로 언제까지 확인할지 쓴다. “문제없음"으로 취급해서는 안 된다. 어떤 항목을 뒤로 미루려 해도 코드 위치나 실행 추적처럼 재현 가능한 증거가 있어야 한다. 도구가 더 보고하지 않았다는 것만으로는 부족하다.
AI는 증거를 모으고, 닫는 것은 사람이 정한다
AI는 첫 번째 정리에 잘 맞는다. 의존성 목록을 읽고, 코드에서 문제의 함수를 부르는지 찾고, KEV와 대조하고, 어떤 입구가 외부 데이터를 받는지 찾아낸다. 그다음 경고마다 증거 카드를 써서 “도구가 말한 것”, “코드가 보여 주는 것”, “아직 확인되지 않은 것"을 나눈다.
하지만 “이건 실행되지 않으니 닫아도 된다"는 판단은 나중의 코드 변경으로 뒤집힐 수 있다. 경고를 닫거나 우선순위를 낮추는 일은 서비스 책임자가 확인한 뒤에 하고, 새 입구 추가, 구조 변경, 버전 업그레이드 같은 재확인 조건도 적어 둔다. 순서를 정한 뒤 AI가 만든 수정본을 바로 배포해도 되는지는 별개의 문제다. AI는 취약점 패치를 쓸 수 있다, 배포할 수 있는지는 문제가 생겼을 때 되돌릴 수 있느냐에 달렸다를 참고하자.
세 가지 질문은 점수보다 시간이 든다
이 세 가지 질문은 점수보다 실제 위험에 가깝지만 시간도 더 든다. 경고 300건의 실행 경로를 모두 추적할 수는 없으니, 먼저 KEV와 “공개 입구 뒤에 있는가"로 대략 거르고, 남은 몇 건을 깊이 확인한다.
CISA는 SSVC라는 의사 결정 방법도 공개했다. 악용 여부, 기술적 영향, 업무에서의 중요도 같은 조건으로 취약점을 대응 단계별로 나누는 방식으로, 이 판단을 정식으로 업무 흐름에 넣고 싶은 팀에 참고가 된다. 컨테이너 이미지 스캔 경고가 특히 많다면 AI 컨테이너 스캐너도 스스로 여기에 선을 긋는다, 기계적인 수정은 자동으로, 베이스 이미지 교체는 사람이 정한다을 함께 보자.
다음 단계로, 같은 서비스에서 경고 다섯 건을 골라 보자. 점수는 높지만 실행되지 않을 수 있는 것, 점수는 보통이지만 공개 입구 뒤에 있는 것, KEV에 오른 것을 일부러 넣는다. 세 가지 질문으로 다시 줄을 세우고, 원래의 점수 순서와 비교해 어느 것이 자리를 옮겼는지 확인한다.
AI 정리 카드
보안 스캔에서 취약점 경고가 대량으로 왔다. 점수만이 아니라 실제 긴급도로 순서를 정하고 싶다.
판단 방법은 이 글에서 가져왔다: https://boosterminiclass.com/ko/posts/ai-vulnerability-evidence-card-prioritization/
글의 관점은 이렇다. 스캔 점수는 취약점 자체의 심각도를 잴 뿐, 이 시스템에서의 긴급도가 아니다. 차례로 묻는다. 밖에서 이미 악용되고 있는가(예: CISA KEV에 올라 있는가), 서비스가 실제로 그 코드를 실행하는가, 외부 입력이 거기까지 닿는가. 답하지 못한 것은 검증 필요로 적고, 문제없음으로 취급하지 않는다.

내가 허락한 코드, 의존성 목록, 스캔 보고서, 실행 기록만 읽기 전용으로 살펴 달라. 파일, 설정, 티켓을 바꾸지 말고 경고도 닫지 말 것.
1. 스캔 결과에서 경고를 최대 다섯 건 골라 각각 취약점 번호, 패키지와 버전, 스캔 점수를 적을 것;
2. 한 건씩 세 질문에 답하고, 모든 답에 직접 근거(파일 경로와 줄 번호, 보고서 항목, 또는 실행한 읽기 전용 명령과 출력)를 붙일 것. KEV에 있는가, 서비스가 문제의 코드를 실행하는가, 어떤 외부 입력이 닿는가;
3. 도구의 주장, 코드에서 확인한 사실, 아직 확인되지 않은 추론을 나눠 적을 것;
4. 세 답을 바탕으로 다시 순서를 매기고, 원래 점수 순서와 비교해 어느 것이 왜 움직였는지 설명할 것.
답하지 못한 것은 모두 "검증 필요"로 적고, 누가 어떤 방법으로 확인할지 제안할 것. 경고 닫기, 우선순위 낮추기, 수정, 배포는 책임자에게 맡길 것.
참고 자료
- FIRST official specification: Common Vulnerability Scoring System v4.0 Specification Document — https://www.first.org/cvss/v4.0/specification-document (2023-11-01)
- CISA official catalog: Known Exploited Vulnerabilities Catalog — https://www.cisa.gov/known-exploited-vulnerabilities-catalog [accessed: 2026-10-11]
- CISA: CISA Releases SSVC Methodology to Prioritize Vulnerabilities — https://www.cisa.gov/news-events/alerts/2022/11/10/cisa-releases-ssvc-methodology-prioritize-vulnerabilities (2022-11-10)