2026년 6월, Anthropic은 Claude Fable 5를 내놓았다. 공식 설명에 따르면 분류기가 요청이 사이버 공격, 생물·화학, 또는 “증류"와 관련 있다고 판단하면, 한 세대 앞의 Opus 4.8이 대신 답한다. 증류는 강한 모델의 출력을 대량으로 뽑아 다른 모델 학습에 쓰는 것이다. Anthropic은 그 전에도 허가 없는 증류를 막는 이유를 설명하는 보고서를 냈다.
그런데 Gizmodo 보도에 따르면 최첨단 모델 개발 용도를 겨냥한 보호 장치 하나는 처음에 사용자에게 보이지 않도록 설계되어 있었다. 거절하지도, 모델을 바꾸지도 않고, 요청을 몰래 고쳐 결함 있는 결과를 내놓은 것이다. 연구자와 개발자들의 거센 반발 뒤에 Anthropic은 “잘못된 절충을 했다"고 인정하고 공개 사과했으며, 이런 보호 장치를 사용자에게 보이게 하겠다고 약속했다.
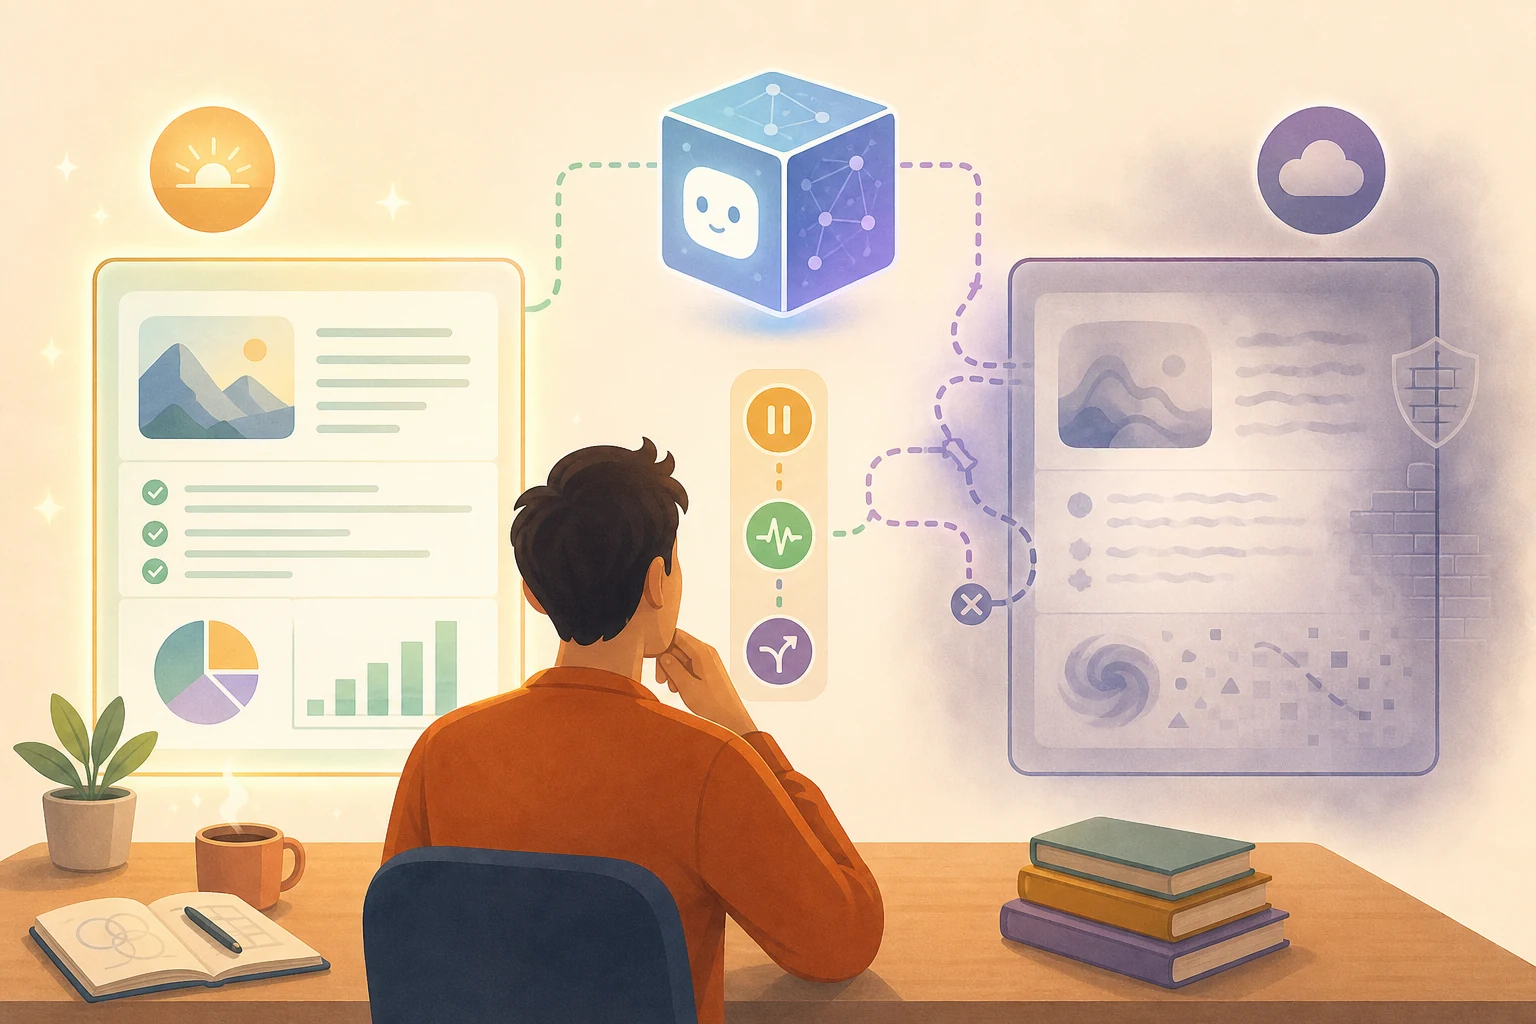
이 교훈은 한 회사에만 해당하지 않는다. 공급자 쪽의 규칙, 라우팅, 보호 장치는 언제든 바뀔 수 있고, 우리는 그것을 볼 수 없다. 손에 쥘 수 있는 것은 내 쪽뿐이다. 중요한 흐름마다 고정 문제와 그때의 답을 남겨 두고, 품질이 바뀐 것 같으면 다시 돌려 비교해, 인상이 아니라 증거로 판단한다.
“어제가 더 나았다"는 대개 인상일 뿐이다
어제는 연구 요약을 깔끔하게 정리해 주던 같은 도구가 오늘은 흐릿하고 세부를 피한다. 반사적으로 프롬프트를 고치고, 대화를 새로 열고, 말을 바꿔 본다. 프롬프트가 원인일 때도 있다. 하지만 원인이 공급자 쪽에 있다면 그런 노력은 모두 짐작일 뿐이다.
더 곤란한 것은 “어제가 더 좋았다"가 대개 인상에 불과하다는 점이다. 어제의 입력과 출력을 저장해 두지 않았다면 품질이 정말 바뀌었다고 증명할 수 없고, 언제부터 시작돼 어떤 결과에 영향을 줬는지도 알 수 없다.
중요한 흐름마다 고정 문제를 만든다
출력이 다른 사람에게 전달되거나, 납품되거나, 정식 버전에 들어가는 흐름을 고른다. 연구 요약, 고객 답장 초안, 코드 수정 같은 것이다. 흐름마다 대표적인 입력을 다섯에서 열 개 골라, 그때의 모델 이름, 날짜, 출력과 함께 저장한다.
품질이 바뀐 것 같으면 같은 문제로 다시 돌려 저장된 답과 비교하고, 어떤 변화인지 본다.
분명한 거절: 모델이 답할 수 없다고 말한다. 적어도 제한이 있다는 것은 알 수 있고, 공식 설명을 찾아볼 수 있다.
짧아지고 흐릿해짐: 예전에는 주던 세부가 빠진다. 모델이 다른 것으로 바뀌었거나, 서비스가 업데이트됐거나, 보호 장치가 추가됐을 수 있다.
특정 유형의 문제만 나빠짐: 예를 들어 보안, 의료, 데이터 추출 관련 문제만 나빠지고 나머지는 정상이다. 대개 그 분야의 규칙이 바뀌었다는 뜻이다.
작업 방향 바꿔치기: 평가를 부탁했는데 주의 문구가 돌아오고, A를 물었는데 더 무난한 B가 돌아온다. 가장 위험한 경우다. 답한 것처럼 보이지만 원한 것이 아니다.
확인할 때는 먼저 공급자의 상태 페이지, 변경 기록, 모델 문서를 본다. Fable 5의 공식 설명은 이제 Opus 4.8이 대신 답할 때 사용자에게 알린다는 점, 그런 일이 전체 대화의 5% 미만에서 일어난다는 점, 분류기가 정상적인 요청을 잘못 잡을 때도 있다는 점을 밝히고 있다. 적혀 있는 규칙이 있어야 대조할 수 있다.
작업 위험도에 따라 대응을 정한다
아이디어 초안이나 말투 다듬기처럼 위험이 낮은 작업이라면, 품질이 떨어질 때 프롬프트나 도구를 바꾸면 되고 큰 대응은 필요 없다.
연구 요약, 내부 보고서, 코드 초안처럼 위험이 중간인 작업이라면 모델을 바꿔도 되지만, 입력과 출력의 차이를 남겨 새 결과를 예전 결론과 바로 비교하지 않게 한다.
보안 심사, 계약 문구, 고객 약속, 운영 코드 병합처럼 위험이 높은 작업이라면, 고정 문제에서 차이가 나오는 즉시 납품을 멈추고, 핵심 사례를 다시 시험하고, 재개 시점은 담당자가 정한다. 공급자가 어떤 변경이 원래 보이지 않았다고 인정했다면 영향을 받은 기간의 결과는 모두 다시 점검해야 한다.
고정 문제라는 방식은 AI에게 코드를 자동으로 고치게 하기 전에 평가 기준을 정해 두는 것과 같은 이치다. AI에게 더 빠른 코드를 자동으로 찾게 하기 전에, 무엇이 “더 나은” 것인지부터 적어 둔다를 참고하자.
고정 문제는 시험한 범위만 잡아낸다
고정 문제는 시험한 범위만 잡아낸다. 공급자의 보호 장치는 특정 유형의 요청만 겨냥하는 경우가 많아서, 문제가 그 부분을 포함하지 않으면 차이가 보이지 않는다. 흐름이 바뀌는 데 맞춰 문제도 주기적으로 손봐야 한다.
또 차이를 찾아냈다고 원인을 알 수 있는 것은 아니다. “바뀌었다"는 것은 확실해도 “왜"인지는 모르는 경우가 많다. 그래도 결정을 내리기에는 충분하다. 어떤 납품을 멈추고 어떤 도구로 바꿀지 정할 수 있다. AI가 언제 멈추고 사람에게 물어야 하는지는 AI를 업무 흐름에 연결하기 전에, 언제 멈추고 사람에게 물을지 정해 둔다를 참고하자.
AI 정리 카드
팀에서 AI에 기대는 중요한 흐름 몇 가지에 고정 문제를 만들어 두고 싶다. AI 출력 품질이 갑자기 바뀌었을 때 인상이 아니라 증거로 판단하기 위해서다.
판단 방법은 이 글에서 가져왔다: https://boosterminiclass.com/ko/posts/claude-fable-invisible-guardrail-checklist/
글의 관점은 이렇다. 공급자 쪽의 규칙, 라우팅, 보호 장치는 사용자가 보지 못하는 사이에 바뀔 수 있다. 손에 쥘 수 있는 것은 내 쪽뿐이다. 중요한 흐름마다 고정 문제와 그때의 답을 남기고, 품질이 바뀐 것 같으면 다시 돌려 비교한 뒤, 작업 위험도에 따라 납품을 멈출지 정한다.

먼저 나에게 물어 달라. 어떤 흐름에서 AI를 쓰는지, 각 흐름의 출력을 누구에게 넘기는지, 지금 어떤 모델을 쓰는지.
그다음:
1. 흐름을 "낮음", "중간", "높음" 위험으로 나누고 이유를 적을 것;
2. 중간과 높음 위험의 흐름마다 고정 문제를 다섯에서 열 개 설계할 것. 일반적인 상황과 제한받기 쉬운 상황을 모두 넣고, 무엇을 저장할지(모델 이름, 날짜, 입력, 출력)도 밝힐 것;
3. 다시 돌린 뒤의 비교 방법을 쓸 것. "분명한 거절", "짧아지고 흐릿해짐", "특정 유형만 나빠짐", "작업 방향 바꿔치기" 네 가지를 구분할 수 있게;
4. 차이가 생겼을 때 먼저 확인할 공식 정보와, 어떤 납품을 멈추고 누가 재개를 정할지 적을 것.
어느 공급자에게 문제가 있는지 나 대신 판단하지 말 것. 방법만 정리할 것.
참고 자료
- Gizmodo: Anthropic Apologizes For One of the Guardrails on Its Fable 5 Model, and Will Change It — https://gizmodo.com/anthropic-apologizes-for-one-of-the-guardrails-on-its-fable-5-model-and-will-change-it-2000770365 (2026-06-11)
- Anthropic official announcement: Claude Fable 5 and Claude Mythos 5 — https://www.anthropic.com/news/claude-fable-5-mythos-5 (2026-06-09)
- Anthropic official announcement: Detecting and preventing distillation attacks — https://www.anthropic.com/news/detecting-and-preventing-distillation-attacks (2026-02-23)