一個資料團隊每天要跑一次的排程計算,要四十分鐘才算完。工程師把這段程式交給一個自動優化工具,設定目標是「越快越好」。一個晚上之後,工具交回一個只要十二分鐘的版本,測試也都通過。隔週,對帳時發現有幾筆金額的小數點後幾位和以前不一樣:新版本為了速度,改用了精度較低的計算方式,而原本的測試剛好沒有檢查那幾位數。
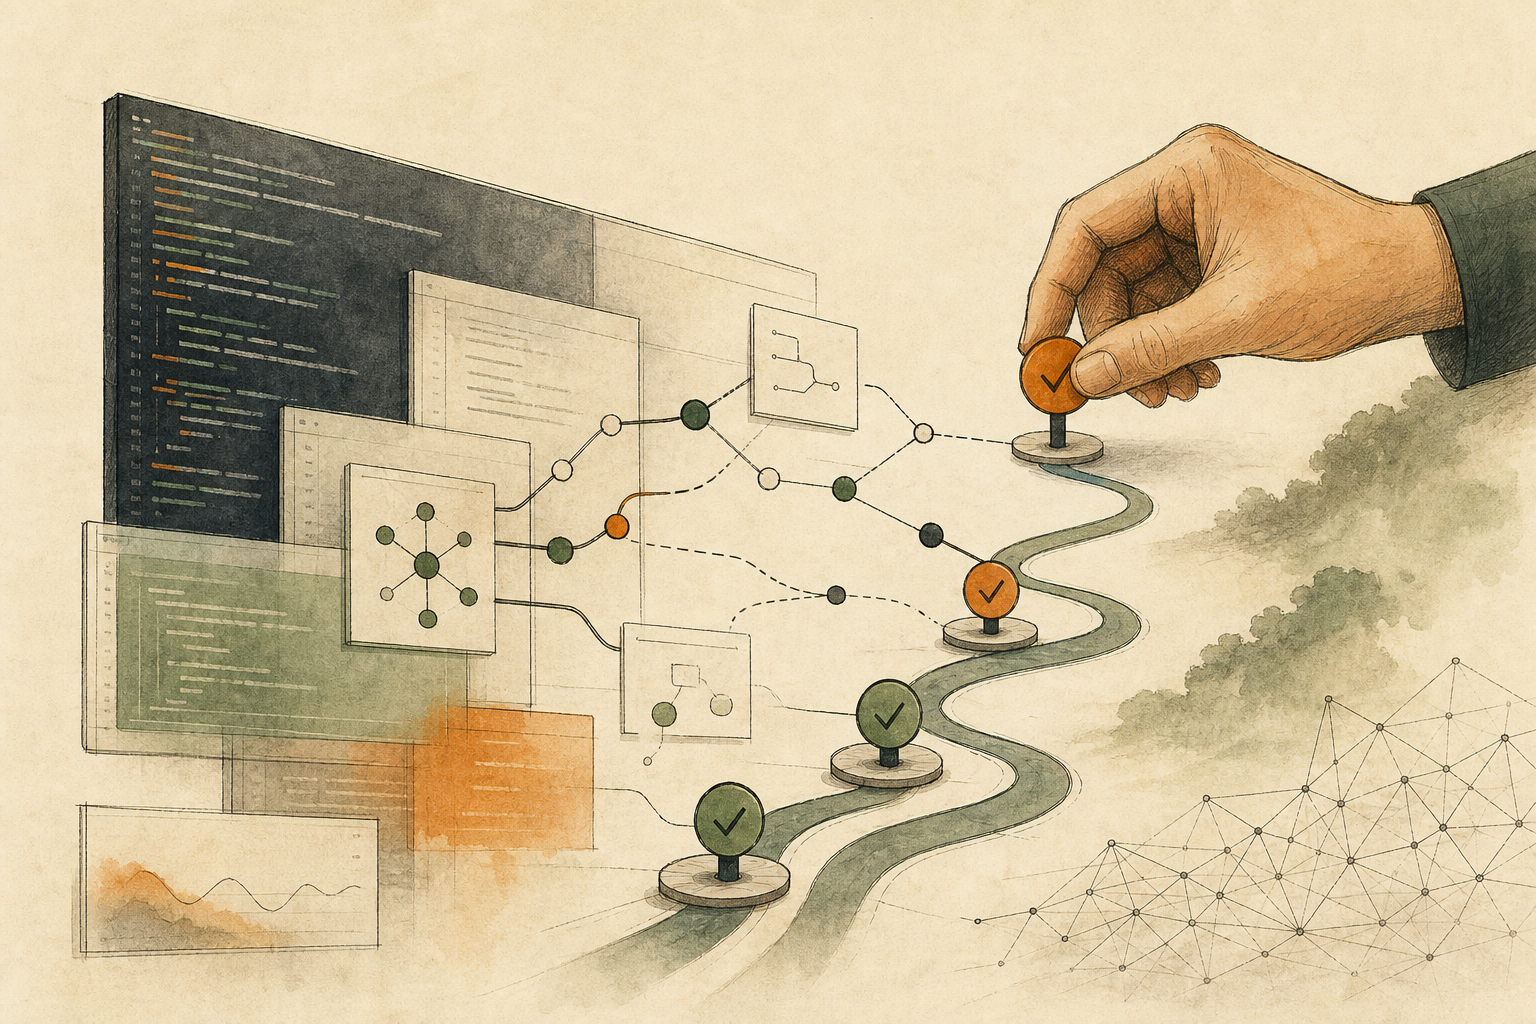
2026 年 7 月,Google Cloud 把 AlphaEvolve 開放給企業使用。這是一個建立在 Gemini 模型上的程式優化工具:使用者提供一段起始程式和一支評分程式,它會反覆產生大量修改版本、交給評分程式打分數,留下分數最高的。這種工具確實能找到人想不到的解法,但它只看評分程式量得到的東西。所以,交給它之前,團隊要先把「更好」寫成可以執行的條件,而不只是「跑快一點、品質不要變差」。
它只優化被量到的東西
Google DeepMind 在 2025 年首次介紹 AlphaEvolve 時就說明,它會用自動化的評估指標驗證、執行並替每個候選程式打分數,分數好的版本會被保留下來,影響下一輪產生的方向。也因為一切都靠分數,這類工具最適合進步能被清楚量測的領域。
Google Cloud 的說明把使用流程整理成四步:定義起始程式與問題、建立評分方式、讓工具優化、把結果套用到正式環境。其中評分程式由使用者自己提供,必須是一支結果固定、可重現的腳本,負責編譯、測試並回傳分數。
問題就出在這支腳本。InfoQ 報導這項服務時直接提醒:演化式的搜尋會利用評分程式沒量到的任何東西,例如產生一段速度很快、卻有細微錯誤而測試抓不到的程式。報導也指出,目前公開的成效數字都來自 Google 或客戶自己的說法,還沒有獨立的基準測試。
開頭那個團隊遇到的就是這件事。評分程式量了速度,沒量精度,工具就用精度換了速度。
交給它之前,先寫一份評估契約
所以,交給自動優化工具的不該只是一個目標,而是一份能被執行的契約。它至少要回答五件事:
- 基準: 拿哪個版本、在什麼環境下比較。
- 分數: 「更好」怎麼算成數字,例如執行時間、記憶體用量。
- 硬性限制: 即使分數更高也絕對不能違反的條件,例如結果必須和舊版完全一致、輸出格式不能改、記憶體不能超過某個上限。每一條都要寫成評分程式會自動檢查的測試。
- 停止條件: 花多少運算預算、多少時間,或連續多少輪沒有進步就停下來。
- 放行的人: 一位具名的人負責看過修改內容和檢查結果,決定要不要用。
這五項裡最容易漏掉的是硬性限制。人在審查時,會自然想到「這個數字不能變」;但沒寫進評分程式的條件,對工具來說就不存在。
怎麼判斷一個目標適不適合
寫契約的過程本身就是一個判斷。可以照這個順序問:
- 結果能客觀打分數,限制也都能自動檢查: 可以開始,但限定修改範圍和預算,由人審查結果,不要自動部署。
- 能打分數,但「能不能用」還要靠經驗判斷: 先別開始。把一個常見的否決理由寫成測試,補進評分程式,再看還剩下哪些判斷無法自動化。
- 好壞要靠人的品味,或錯了的代價無法事先攔住: 不適合自動搜尋。AI 可以幫忙整理選項,但決定和責任仍在人身上。
通過評分,不代表需求完整
即使評分程式寫得很完整,通過它也只代表候選程式符合已經寫下的條件,不代表需求本身完整。每次執行最好保留起始版本、環境、分數、限制檢查結果和停止原因,讓負責放行的人能看到完整證據;必要時,還要再做安全、維運和產品層面的檢查。
寫評分程式本身也需要時間。對只會跑幾次、慢一點也沒關係的程式,花這個力氣不划算。值得投入的,是每天執行、成本或速度的差距會一直累積的那種計算。
先挑一個邊界清楚、團隊早就想加速的計算,試著寫下那五項。哪一項寫不出來,就先補那一項,不必急著讓 AI 多產幾個版本。候選程式交回來之後,誰負責理解和維護它,參考〈AI 交出的第一版程式是試價,真正的帳單是審查和維護〉;搜尋過程中要在哪些地方停下來看證據,參考〈一張 issue 能不能交給 coding agent,看你寫不寫得出第一個 diff〉。
AI 整理卡
我想讓一個自動優化工具(例如 AlphaEvolve 這類會反覆產生程式版本、依分數挑選的工具)改善一段程式,想先判斷這個目標適不適合。
判斷方法來自這篇文章:https://boosterminiclass.com/posts/ai-code-optimization-needs-evaluator-contract/
文章的看法是:這類工具只優化評分程式量得到的東西,沒寫進去的限制可能被犧牲。交給它之前,要先寫一份評估契約:基準、分數、硬性限制、停止條件、放行的人。

請先問我 3 個問題:
1. 想優化的是哪一段程式,目前的效能和比較環境是什麼;
2. 「更好」要怎麼算成數字,有哪些條件即使分數更高也不能違反;
3. 這些條件目前有沒有自動化的測試,誰負責決定要不要採用新版本。

根據我的回答,請輸出:
- 一份評估契約草稿:基準、分數、硬性限制(每條標明是否已有自動測試)、停止條件、放行的人,缺少的寫「待確認」;
- 評分程式最可能漏量、會被工具鑽漏洞的地方;
- 一行判斷:可以開始/先補評分程式/不適合自動搜尋,並說明最關鍵的理由;
- 今天可以完成、不會直接部署的一個下一步。
不要修改任何程式或設定;任何高分版本都要由具名的負責人看過差異和檢查結果後,才能進入發布流程。
參考來源
- Google Cloud Blog:Solve harder problems with AlphaEvolve, now available to everyone on Google Cloud — https://cloud.google.com/blog/products/ai-machine-learning/alphaevolve-is-available-for-everyone(2026-07-10)
- InfoQ:Google’s AlphaEvolve Reaches General Availability with Evolutionary Code Optimization as a Service — https://www.infoq.com/news/2026/07/alphaevolve-generally-available/(2026-07-19)
- Google DeepMind Blog:AlphaEvolve: A Gemini-powered coding agent for designing advanced algorithms — https://deepmind.google/discover/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/(2025-05-14)