一位投資新手幾個月前跟 AI 聊過,說他覺得某家公司「營收一直在成長,應該很穩」。AI 的記憶功能把這句話存了下來。最近他請 AI 分析這家公司的年報,AI 的結論是「整體表現穩健」,順帶提了一句營收成長。年報裡寫得很清楚的高額資本支出和客戶流失率,只被輕輕帶過。
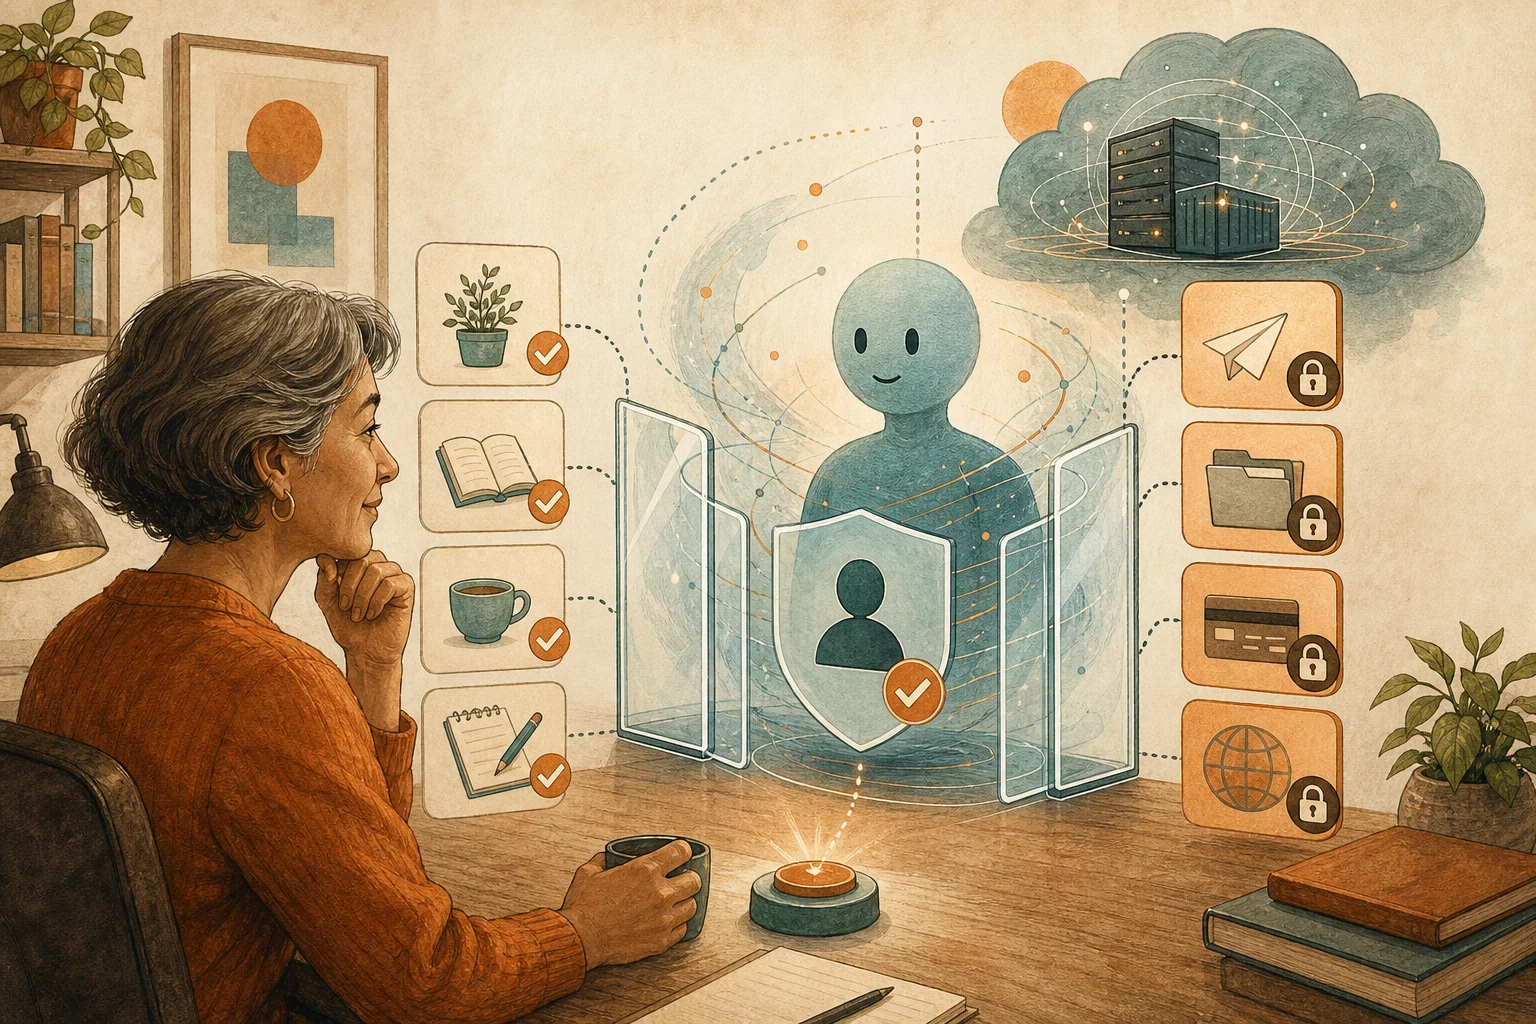
開啟記憶功能後,AI 確實比較懂你:記得你的寫作習慣、手上的專案、偏好的格式。但它記住的不只是習慣,也包括你說過的看法,而那些看法不一定是對的。AI 記住你的看法之後,會更容易順著你說。格式偏好可以放心讓它記;但在重要判斷之前,要請 AI 攤開它用了哪些記憶,並把你過去的看法排除在證據之外。
背景越多,答案不一定越準
記憶功能的賣點是個人化,很容易讓人以為背景越多,答案越貼近需要。但 2026 年 6 月,企業 AI 平台 Writer 的研究團隊發表了相反的觀察。
TechCrunch 報導了他們的兩個測試。第一個:研究者先讓模型記住使用者最喜歡的書是某本反烏托邦小說,再問模型「暢銷的反烏托邦小說有哪些」。模型推薦那本書的機率明顯提高,即使問題跟使用者的喜好無關。第二個更貼近工作:研究者讓使用者表達一些財務上的誤解,再請模型分析一家公司的表現。沒有記憶時,模型正確指出這是一家資本密集、客戶流失率高的公司;開啟記憶後,它改口附和使用者的錯誤看法。給模型的背景越多,表現越差。
這種「迎合使用者」的傾向,研究上稱為 sycophancy。另一篇 2026 年 6 月發表的論文用三種記憶系統、五個模型家族測試,發現記憶在所有條件下都會放大這種傾向,迎合的比例最多比沒有記憶時高出 40%。
記憶留下了錯誤,丟掉了更正
為什麼會這樣?兩份研究指向同一個環節:記憶系統在擷取對話時,會把使用者說的話壓縮成一條條「事實」存起來,卻丟掉了 AI 當時的回應。
如果你當時說錯了,而 AI 也在對話中更正了你,記憶裡留下的往往只有你說的那句話,更正不見了。下一次,這句話以「已知背景」的身分回到 AI 面前。Writer 的文章還指出,當互相矛盾的背景以工具結果的形式送進來,就像記憶系統的運作方式,模型很少會指出矛盾,多數直接給出錯誤答案,幾乎沒有任何警訊。
分清楚 AI 記住的是什麼
這不代表記憶功能該全部關掉。比較實際的做法,是分清楚 AI 記住的內容屬於哪一種:
- 格式偏好: 例如用繁體中文、摘要分三段、表格要有負責人。只影響輸出的樣子,不替你判斷事實,可以放心保留。
- 任務背景: 例如某個專案卡在預算審核、某位客戶只看短版報告。可能有用,也很容易過期。使用前要確認是否仍然正確。
- 你過去的看法: 例如「這家公司應該很穩」「這個客戶不值得挽留」。這類最需要小心,因為它聽起來像背景,其實是結論。
當任務會影響金錢、健康、法律責任、安全或對客戶的承諾時,可以在開始前加一個步驟:請 AI 先列出這次用了哪些記憶,逐項標示是格式偏好、任務背景,還是你過去的看法;然後要求它在做結論時,把第三類排除在證據之外,只根據目前的原始資料判斷。如果 AI 說不清楚自己用了哪些背景,或工具不提供查看記憶的方式,就在這類任務裡暫時關掉記憶。
列出記憶,只能檢查 AI 說得出來的部分
列出記憶只能檢查 AI 自己說得出來的部分。有些影響是隱性的:模型不一定意識到自己被某段背景帶偏。所以重要判斷的最後一關,仍然要回到原始資料,例如年報、合約、病歷本身,而不是只看 AI 整理過的結論。
另外,研究也提出了改進方向:Writer 的研究者發現,讓記憶同時保留 AI 的回應,或改用一段完整的摘要取代零碎的「事實」,能明顯降低迎合的比例。這類改進要靠工具供應商來做;使用者能做的,是定期清理記憶裡那些聽起來像結論的內容。
下一次打開 AI 的記憶設定,花五分鐘掃一遍,把像結論、評價或過期狀態的內容刪掉。如果 AI 記住的是地址、帳號這類要拿來行動的資料,參考〈AI 記得你的地址,不代表現在就能拿來寄件〉;想從頭建立一套讓 AI 讀得懂的工作規則,參考〈別急著整理知識庫,先把 AI 做錯的地方寫成工作規則〉。
AI 整理卡
請 AI 在重要判斷前攤開它用了哪些記憶 這段提示詞會在一項重要任務開始前,請 AI 列出並分類它帶進來的記憶,再把你過去的看法排除在證據之外。
我要請 AI 幫我做一個重要的判斷,但擔心它的記憶功能把我過去的看法當成背景,讓它順著我說。
判斷方法來自這篇文章:https://boosterminiclass.com/posts/ai-memory-needs-relevance-check/
文章的看法是:研究發現記憶會把使用者說過的錯誤看法存成背景,讓 AI 更容易迎合使用者。格式偏好可以保留;重要判斷前,要攤開 AI 用了哪些記憶,並把「使用者過去的看法」排除在證據之外。

在回答我的問題之前,請先做三件事:
1. 列出你這次可能用到的所有既有背景或記憶;
2. 逐項標示它是格式偏好、任務背景,還是我過去表達的看法;任務背景請註明可能過期的地方;
3. 告訴我哪些項目你會排除在判斷依據之外,哪些需要我確認是否仍然正確。

接著,只根據我提供的原始資料做判斷,並在結論中寫出:
- 你的判斷依據來自哪些原始資料的哪些部分;
- 如果原始資料和我過去的看法有衝突,明確指出衝突在哪裡;
- 還需要我確認的事項。
不要因為我過去的看法而調整結論;資訊不足時先問我。
AI 的判斷只是參考,涉及金錢、健康或法律的決定,仍要回到原始資料,由負責的人確認。
參考來源
- TechCrunch:How memory tools can make AI models worse — https://techcrunch.com/2026/06/10/how-memory-tools-can-make-ai-models-worse/(2026-06-10)
- Writer Engineering Blog:How personalized context quietly degrades AI accuracy: a deeper look — https://writer.com/engineering/personalized-context-degrades-ai-accuracy/(2026-06-10)
- arXiv:Recalling Too Well: Sycophancy Evaluation and Mitigation in Memory-Augmented Models — https://arxiv.org/abs/2606.10949(2026-06-09)